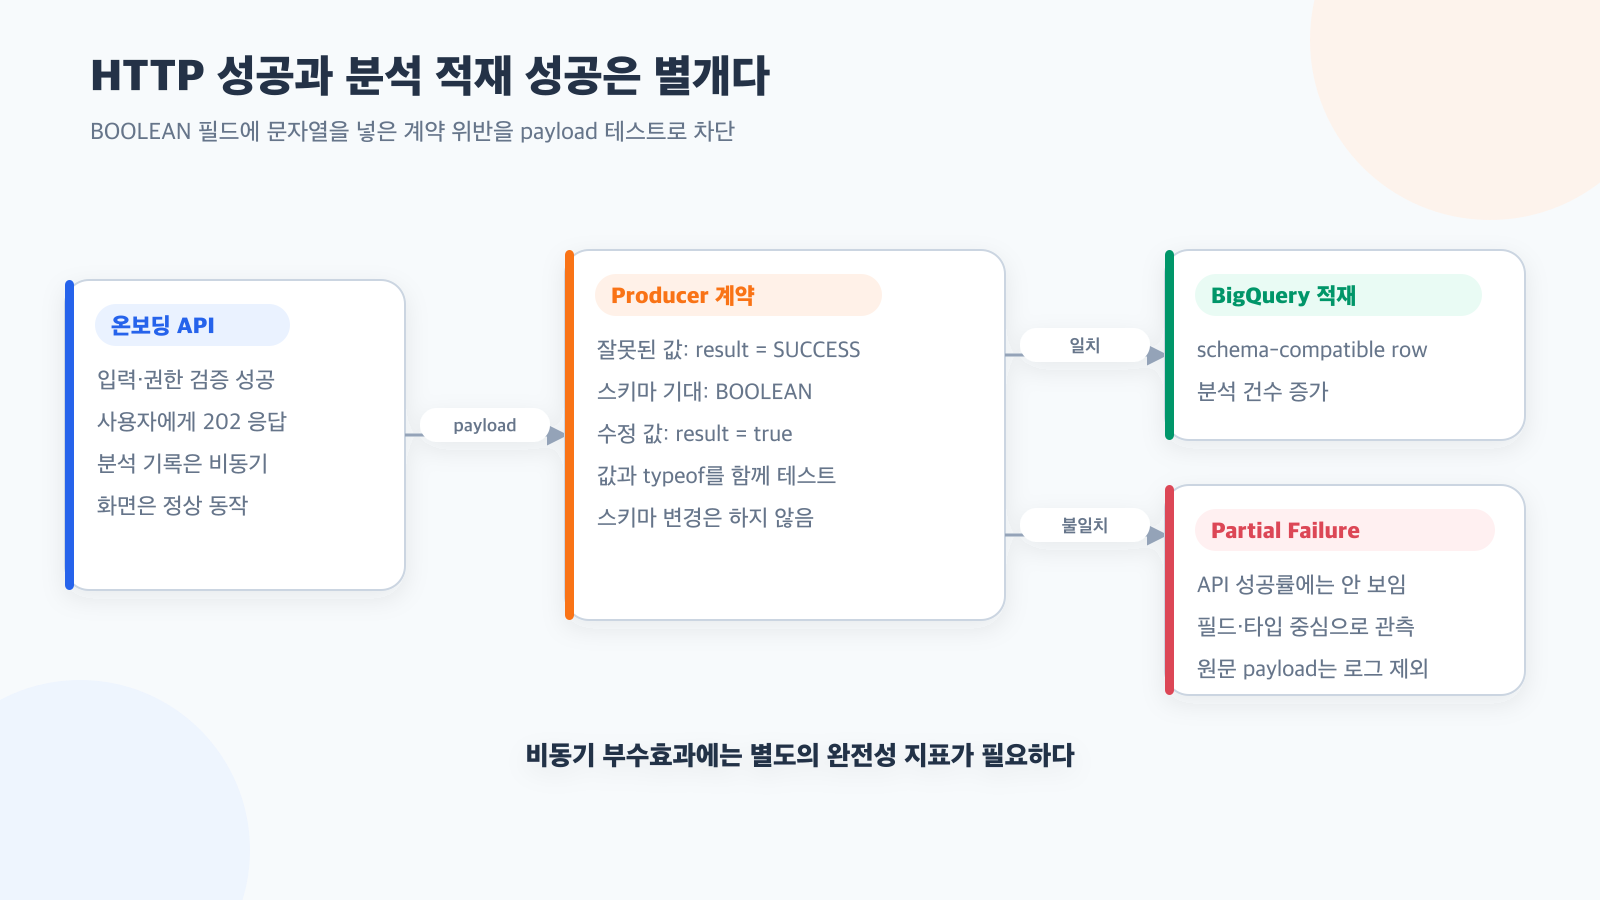
사용자의 온보딩 행동을 기록하는 API는 정상적으로 202 Accepted를 반환했다. 화면에서도 오류가 없었다. 그런데 분석 데이터는 BigQuery에 들어오지 않았다.
원인은 거창한 장애가 아니었다. BigQuery 스키마에서 BOOLEAN인 필드에 애플리케이션이 "SUCCESS"라는 문자열을 보냈다. 의미는 사람에게 비슷해 보였지만, 데이터 계약에서는 완전히 다른 타입이었다.
이 사례는 “API 성공”과 “부수적인 분석 기록 성공”을 구분하는 방법, 그리고 작은 payload 테스트가 스키마 전체 변경보다 더 정확한 해결일 수 있다는 점을 보여줬다.
성공 응답 뒤에 숨은 부분 실패
분석 이벤트는 사용자 요청의 핵심 기능이 아니었다. 이벤트 기록 때문에 온보딩 화면이 실패하지 않도록 BigQuery insert는 비동기로 호출하고, 오류는 로그만 남겼다. 이 선택 자체는 사용자 경험 측면에서 합리적이었다.
하지만 그 결과 두 개의 성공 기준이 생겼다.
- HTTP API가 요청을 검증하고 정상 응답했는가?
- 분석 writer가 schema-compatible row를 실제로 적재했는가?
첫 번째만 모니터링하면 분석 파이프라인은 조용히 비어 갈 수 있다. 이번에도 API 성공률에는 변화가 없었고, BigQuery 클라이언트의 PartialFailureError와 적재 건수에서만 문제가 드러났다.
부분 실패는 batch 전체가 완전히 실패했다는 뜻과도 다르다. 여러 행을 한 번에 넣을 때 일부 행만 schema 오류를 가질 수 있다. 따라서 “insert 호출이 실패했다”라는 한 줄보다 어느 행의 어느 필드가 거부됐는지 구조화해서 봐야 한다. 단, 오류 로그에 사용자 데이터 원문 전체를 그대로 출력해서는 안 된다.
이름이 아니라 타입이 계약이다
문제가 된 payload의 의미는 대략 다음과 같았다.
{
  "action": {"type": "ONBOARDING_EVENT"},
  "result": "SUCCESS"
}
result라는 이름만 보면 성공 여부를 잘 표현한 것처럼 보인다. 하지만 BigQuery BOOL은 TRUE 또는 FALSE의 논리값을 위한 타입이다. 임의의 상태 문자열을 넣는 필드가 아니다.
수정은 단순했다.
{
  "action": {"type": "ONBOARDING_EVENT"},
  "result": true
}
상태 종류가 필요하다면 별도의 STRING 필드나 action JSON 안의 명시적 속성으로 모델링해야 한다. 성공 여부 Boolean에 상태 이름까지 억지로 담으면 producer마다 SUCCESS, OK, COMPLETED, 1 같은 표현이 생긴다.
BigQuery는 분석 저장소이지만 schema가 느슨한 로그 파일은 아니다. 필드 이름, mode, 중첩 구조와 타입은 producer가 지켜야 하는 외부 계약이다.
스키마를 바꾸지 않은 이유
오류가 나면 저장소를 producer에 맞추고 싶은 유혹이 있다. BOOLEAN을 STRING으로 바꾸면 현재 문자열은 들어갈 수 있다. 그러나 기존 쿼리는 Boolean 조건을 기대하고 있었고, 다른 producer도 이미 올바른 논리값을 보내고 있었다.
이번 문제는 도메인 모델이 바뀐 것이 아니라 한 호출부가 계약을 어긴 것이었다. 따라서 스키마 변경 없이 producer의 값만 고쳤다.
판단 기준은 다음과 같다.
- 필드가 실제로 두 상태만 표현하는가?
- 기존 consumer 쿼리가 어떤 타입을 기대하는가?
- 다른 producer는 어떤 값을 보내는가?
- 새 문자열 상태가 장기적으로 필요한가, 단지 코드 상수 선택 실수인가?
스키마 변경은 더 넓은 writer와 reader, 과거 데이터, 쿼리와 대시보드까지 영향을 준다. 한 줄의 타입 오류를 고치기 위해 그 범위를 넓힐 이유가 없었다.
실제 BigQuery 대신 payload 경계를 테스트한다
회귀 테스트에서 매번 BigQuery에 실제 행을 넣을 필요는 없었다. 우리가 증명해야 할 것은 라우트가 공통 BigQuery 유틸리티에 어떤 payload를 전달하는가였다.
테스트는 다음 경계를 가짜 구현으로 바꿨다.
- 인증된 요청을 라우트 handler에 전달한다.
- 접근 가능한 대상인지 확인하는 모델 조회를 test double로 대체한다.
- BigQuery insert 함수를 호출 기록만 남기는 함수로 바꾼다.
- HTTP 응답이
202인지 확인한다. - 전달된
result가 값true이고typeof도boolean인지 확인한다.
값만 true와 동등한지 보는 것으로는 부족하다. 문자열 "true"도 사람 눈에는 비슷하지만 BigQuery 계약에는 맞지 않는다. 그래서 값과 런타임 타입을 함께 고정했다.
이 테스트는 빠르고 실제 분석 데이터를 오염시키지 않는다. 반면 공통 insert utility 자체가 row를 변환한다면 utility 단위의 schema validation 테스트도 별도로 필요하다.
공통 검증을 어디까지 둘까
모든 BigQuery 필드에 범용 schema validator를 만들면 안전해 보인다. 그러나 BigQuery schema를 런타임마다 가져오거나 별도 정의를 중복 관리하면 복잡성과 불일치 지점이 늘어난다.
우리는 우선 사고가 난 producer 계약을 가장 가까운 테스트에 고정했다. 이후 같은 종류가 반복된다면 다음 단계로 확장할 수 있다.
- 이벤트별 TypeScript 또는 JSON Schema 정의
- 공통 writer 앞의 최소 runtime validation
- CI에서 실제 BigQuery schema와 producer fixture 비교
- 잘못된 row를 원문 없이 격리하는 dead-letter 경로
- 이벤트별 생성 수와 적재 수의 차이 모니터링
중요한 것은 validator의 크기가 아니라 schema 불일치가 사용자 응답과 분리되어도 관측에서 사라지지 않게 하는 것이다.
로그에도 최소 정보만 남긴다
Partial failure를 조사하려고 실패 row 전체를 출력하면 이메일, IP, 행동 정보 같은 값이 로그로 복제될 수 있다. 오류 로그에는 다음 정도면 충분하다.
- 대상 이벤트 종류
- 실패 필드 이름과 기대 타입
- BigQuery 오류 reason
- 애플리케이션이 생성한 비식별 event ID
- batch의 성공·실패 행 수
원문 payload가 꼭 필요하다면 접근이 제한되고 보존 기간이 짧은 별도 경로를 사용해야 한다. 운영 로그를 임시 데이터 호수처럼 쓰면 안 된다.
지금 다시 한다면
새 분석 이벤트를 추가할 때 라우트 구현보다 먼저 한 장짜리 계약 fixture를 만들 것이다.
event name
  → producer payload와 런타임 타입
  → BigQuery column과 mode
  → 실패가 사용자 요청에 미치는 영향
  → 적재 성공을 확인할 지표
그리고 배포 후 API 성공 건수와 BigQuery 적재 건수를 같은 시간 구간으로 비교한다. 비동기 분석 이벤트는 사용자 요청을 보호할 수 있지만, 그만큼 별도의 완전성 지표가 필요하다.
핵심은 문자열을 Boolean으로 바꾼 한 줄이 아니다. 비동기 부수효과의 성공을 HTTP 성공과 분리해 관측하고, producer가 저장소 스키마를 지키는지 가장 가까운 테스트에서 증명하는 것이다.