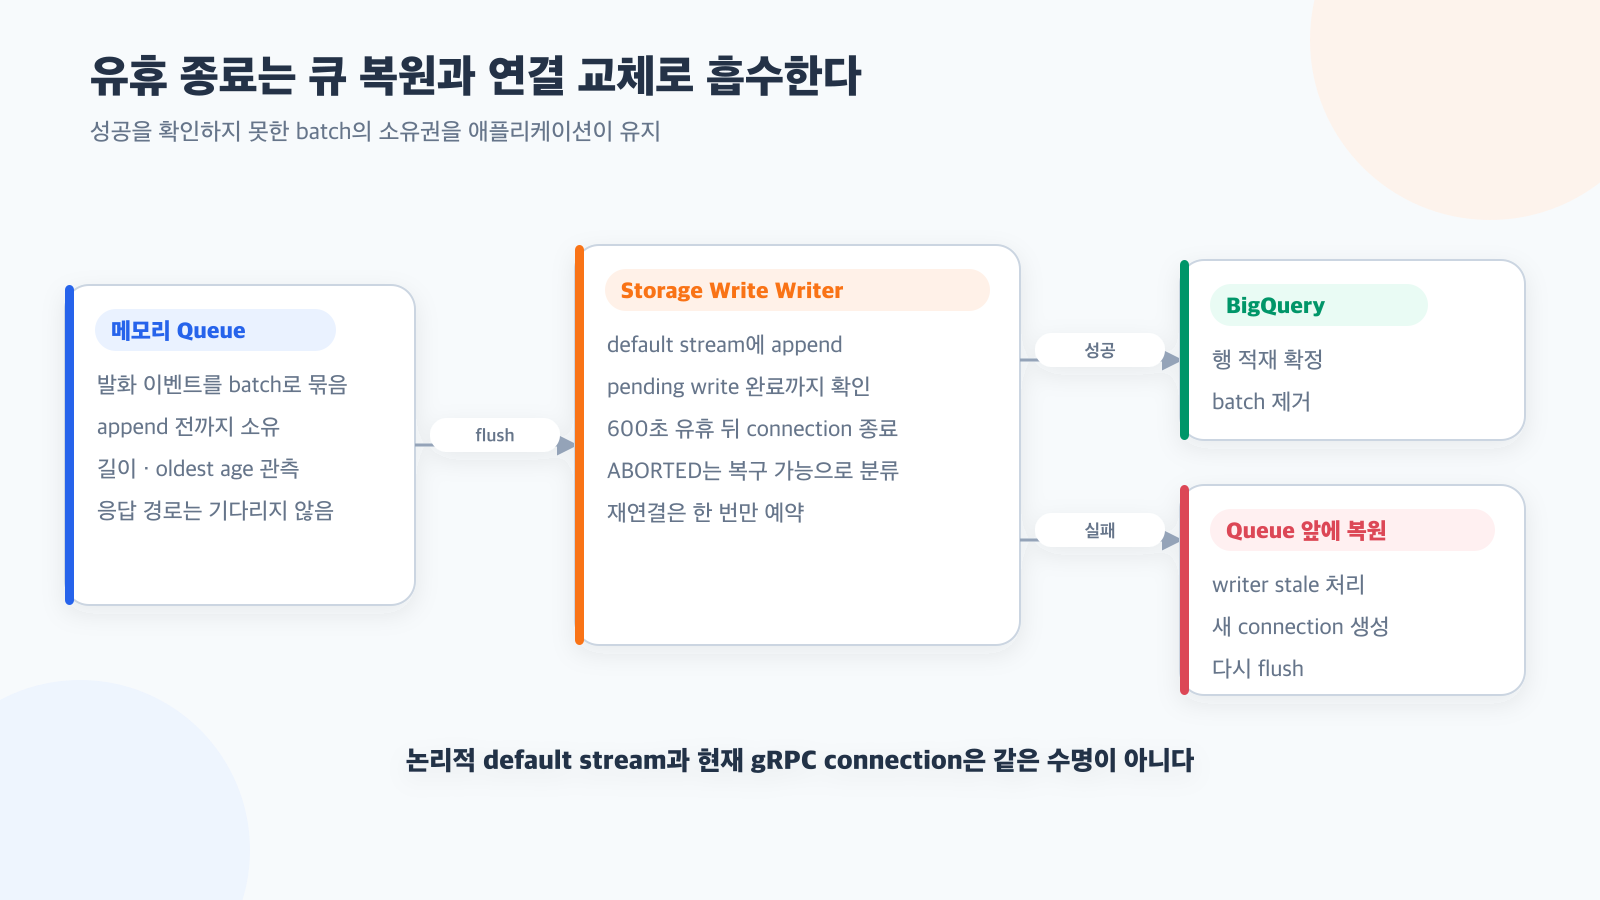
BigQuery Storage Write API의 writer를 애플리케이션 시작 때 한 번 만들고 계속 재사용하면 단순하다. 실제로 평소에는 잘 동작했다. 문제는 대화가 한동안 없던 뒤 다시 로그를 보낼 때 나타났다.
운영에서 사용하던 연결은 600초 동안 비활성 상태가 이어진 뒤 서버 측에서 닫혔다. 다음 배치를 append하자 gRPC ABORTED 오류가 발생했다. 기존 코드는 timeout과 connection reset 계열만 재연결 대상으로 보고 있었기 때문에, 실패한 행은 큐로 돌아왔지만 writer는 계속 오래된 연결을 가리킬 수 있었다.
로그 큐를 복원하는 것과 전송 경로를 복구하는 것은 별개의 일이었다.
기본 스트림도 영구 연결은 아니다
Storage Write API의 기본 스트림은 실시간 적재에 적합하고, 기록한 데이터가 즉시 조회 가능하며 at-least-once 의미를 제공한다. 명시적으로 stream을 생성·commit하는 복잡성도 없다.
하지만 기본 스트림이라는 이름이 하나의 gRPC 연결이 영원히 열린다는 뜻은 아니다. Google Cloud 공식 문서도 연결이 너무 오래 유휴 상태이면 닫힐 수 있고, 연결 오류가 나면 새 연결을 만들라고 설명한다. 일부 클라이언트는 자동 재연결을 지원하지만, 우리가 사용하던 Node.js writer 조합과 오류 처리 계층에서는 실제 append 실패 뒤 애플리케이션 상태까지 명시적으로 복구해야 했다.
중요한 구분은 다음과 같다.
- BigQuery 기본 스트림: 테이블에 데이터를 쓰는 논리적 경로
- gRPC connection: 그 스트림에 append하기 위해 현재 writer가 가진 네트워크 연결
- 애플리케이션 queue: 아직 성공을 확인하지 못한 레코드
논리적 스트림이 존재해도 현재 connection은 닫힐 수 있다. connection을 다시 만들더라도 실패한 batch를 잃으면 복구가 아니다.
기존 retry 판별이 너무 좁았다
초기 구현은 흔히 보던 네트워크 문자열을 중심으로 복구 가능 오류를 판별했다. 그러나 실제 오류는 숫자 코드와 유휴 종료 메시지의 조합으로 나타났다.
오류를 단순히 문자열 하나로 비교하면 SDK나 gRPC 계층에 따라 표현이 달라질 때 놓치기 쉽다. 반대로 모든 오류를 재시도하면 스키마 불일치나 잘못된 payload처럼 재연결로 해결되지 않는 문제까지 무한 반복한다.
그래서 판별을 두 축으로 정리했다.
- gRPC 상태 코드가 연결·인증·일시 장애 계열인지 확인한다.
- 알려진 연결 종료 메시지를 보조 신호로 확인한다.
유휴 종료처럼 정상 운영 중 예상 가능한 이벤트는 낮은 로그 심각도로 분류한다. 알 수 없는 schema·payload 오류는 ERROR로 남기고 writer 재생성만으로 해결될 것처럼 취급하지 않는다.
실패한 batch를 먼저 큐에 되돌린다
flush는 큐에서 최대 batch 크기만큼 꺼낸 뒤 append 결과를 끝까지 기다린다. Node.js managed writer는 append 호출 자체뿐 아니라 반환된 pending write의 완료 결과까지 확인해야 실제 성공 여부를 알 수 있다.
전송이 실패하면 batch를 큐 앞쪽에 원래 순서대로 되돌린다. 그 다음 오류가 복구 가능할 때만 재연결을 예약한다.
queue에서 batch 분리
        ↓
append + 완료 결과 대기
   ├─ 성공 → batch 제거 확정
   └─ 실패 → queue 앞에 복원
                   ↓
             writer stale 처리
                   ↓
             새 연결 생성 후 flush
큐 복원을 재연결보다 먼저 하는 이유는 새 연결 생성도 실패할 수 있기 때문이다. writer 교체 과정에서 레코드의 소유권이 불명확해지지 않게, 성공을 확인하기 전까지 애플리케이션 큐가 데이터를 계속 소유한다.
재연결에도 동시성 제어가 필요하다
연결이 닫히면 connection의 error event와 append 실패가 거의 동시에 들어올 수 있다. 두 경로가 각각 새 writer를 만들면 연결이 중복되고, 늦게 완료된 재연결이 새 writer를 오래된 객체로 덮을 수 있다.
우리는 다음 제약을 뒀다.
- 재연결 중임을 나타내는 단일 플래그를 둔다.
- 예약된 reconnect timer는 하나만 유지한다.
- 마지막 시도 후 최소 간격을 둔다.
- 기존 writer 참조를 먼저 분리하고 close 오류는 끊어진 연결의 정리 실패로 취급한다.
- 새 writer가 준비된 뒤 대기 큐 flush를 다시 깨운다.
- 재연결 자체가 실패하면 같은 최소 간격 뒤 다시 예약한다.
종료 시에는 reconnect timer를 해제하고, 남은 큐를 한 번 전송한 뒤 writer를 닫는다. 로거의 timer만으로 Node.js 프로세스가 계속 살아 있지 않도록 timer를 unref하는 것도 필요했다.
큐가 있다는 이유로 무손실은 아니다
메모리 큐는 BigQuery의 짧은 장애와 연결 교체를 흡수하지만, 프로세스가 강제 종료되면 아직 flush되지 않은 레코드는 사라질 수 있다. 기본 스트림의 at-least-once 특성 때문에 응답을 받기 전 연결이 끊기면 재전송된 일부 레코드가 중복될 가능성도 있다.
따라서 정확히 한 번이 필요한 이벤트라면 애플리케이션 생성 ID로 중복을 제거하거나, offset을 관리하는 application-created stream과 영속 큐를 검토해야 한다. 모든 분석 로그에 그 복잡성이 필요한 것은 아니다. 우리는 사용자 응답을 막지 않는 것과 짧은 장애 후 통계가 회복되는 것을 우선했다.
관측 지표도 writer 연결 여부 하나로 끝나지 않는다.
- 현재 queue 길이와 증가 속도
- 마지막 append 성공 시각
- 재연결 예약·성공·실패 횟수
- 가장 오래 대기한 레코드의 나이
- 중복 제거가 필요한 이벤트의 고유 ID
지금 다시 한다면
SDK가 자동 재연결을 지원한다는 문구만 믿지 않고, 우리가 사용하는 writer 객체의 수명주기와 append 완료 계약을 작은 장애 테스트로 고정할 것이다.
테스트에서는 writer가 유휴 종료 오류를 반환하게 만들고 다음을 확인한다.
- 실패 batch가 순서를 유지한 채 큐로 돌아오는가?
- error event와 append reject가 동시에 와도 재연결은 하나뿐인가?
- 새 writer가 준비되기 전에 flush가 데이터를 버리지 않는가?
- 복구 불가능한 payload 오류는 무한 재연결하지 않는가?
- 종료 시 timer와 writer가 정리되는가?
핵심은 600초를 늘리는 것이 아니다. 장기 SDK 객체의 논리적 역할과 실제 네트워크 연결 수명을 분리하고, 성공을 확인하지 못한 데이터의 소유권을 끝까지 유지하는 것이다.