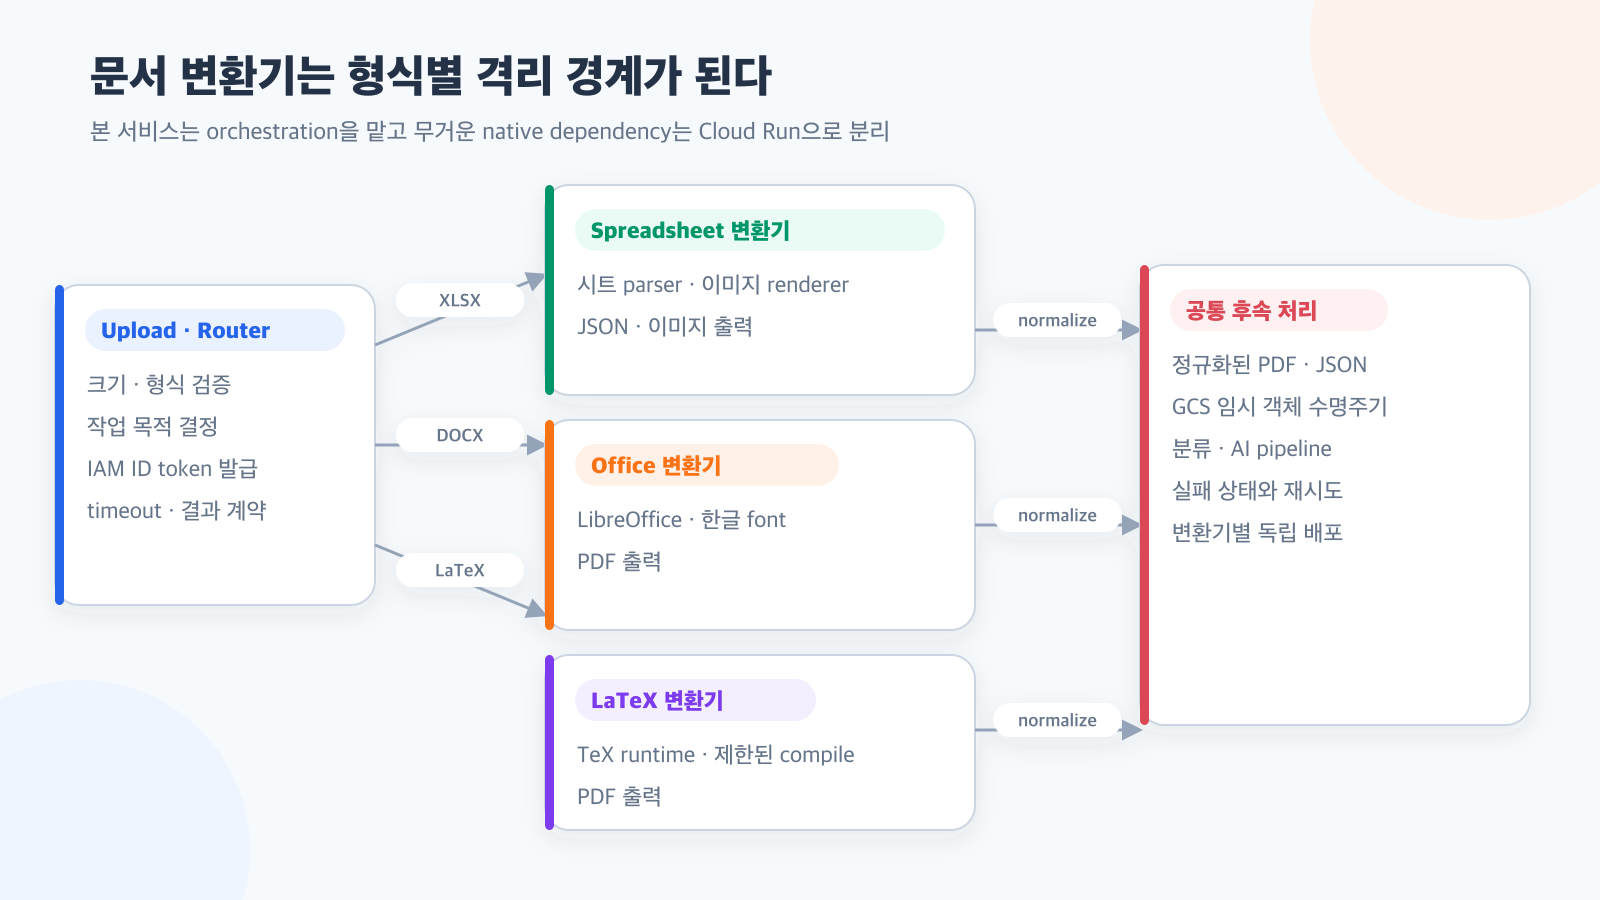
XLSX, DOCX, HWP와 LaTeX를 한 Node.js 서비스에서 모두 변환하려고 하면 애플리케이션 image에 spreadsheet parser, LibreOffice, TeX Live, font와 native library가 함께 들어간다. 배포 image가 커지는 것보다 더 큰 문제는 서로 다른 실패와 보안 경계가 한 process에 섞인다는 점이었다.
우리는 형식별 변환기를 작은 Cloud Run 서비스로 분리하고, 본 서비스는 업로드 검증과 orchestration을 담당하게 했다.
파일 형식마다 필요한 runtime이 다르다
문서 변환은 확장자만 다른 같은 작업이 아니다.
- XLSX → JSON: workbook과 sheet parser가 필요하다.
- XLSX → 이미지: headless browser나 renderer와 font가 필요하다.
- DOCX·HWP → PDF: LibreOffice 계열 runtime이 필요하다.
- LaTeX → PDF: TeX engine, package와 두 번의 compile이 필요할 수 있다.
- PDF → 테이블 JSON: Python, Camelot과 PDF native library가 필요하다.
이 의존성을 메인 API image에 모두 넣으면 간단한 설정 변경도 무거운 converter image 전체를 다시 배포해야 한다. 한 parser의 취약점 패치가 관련 없는 웹 서비스 rollout과 묶인다.
분리 기준은 library가 아니라 failure domain이다
서비스를 package 하나마다 나누지는 않았다. 같은 resource와 실패 특성을 가진 변환을 한 경계로 묶었다.
- LibreOffice process가 멈추거나 메모리를 많이 쓰는 경로
- TeX compile이 CPU와 임시 파일을 사용하는 경로
- spreadsheet를 메모리에 펼치는 경로
- PDF 페이지를 native parser로 순회하는 경로
이렇게 나누면 형식별로 memory, CPU, concurrency와 timeout을 조정할 수 있다. 변환기 하나가 OOM으로 종료돼도 로그인이나 챗봇 설정 API가 함께 내려가지 않는다.
API 계약은 작게 유지한다
변환기 요청은 원본 파일과 최소 옵션만 받는다. 응답은 후속 파이프라인이 사용할 PDF, JSON, 이미지 묶음 또는 임시 객체 참조로 제한한다.
Upload Router
  → 파일 크기·형식·작업 목적 검증
  → 대상 converter 선택
  → IAM ID token으로 private Cloud Run 호출
  → timeout 안에 결과 수신
  → 정규화된 결과만 AI 분류 단계에 전달
Cloud Run 서비스 간 호출은 공개 URL을 안다고 실행되는 구조로 만들지 않는다. 호출 service identity에 필요한 converter의 Invoker 권한만 주고, audience가 대상 service와 일치하는 ID token을 보낸다.
/tmp도 메모리 budget에 포함된다
Cloud Run의 writable filesystem은 in-memory다. 업로드 파일과 변환 산출물을 /tmp에 쓰면 process heap 밖에서도 instance memory를 사용한다. 50MB 입력이 50MB memory만 차지하는 것도 아니다. 압축된 Office 파일을 펼치고 PDF·이미지를 생성하면 중간 산출물이 훨씬 커질 수 있다.
따라서 converter마다 다음 경계를 둬야 한다.
- 요청 파일 크기 제한
- 허용 확장자와 실제 콘텐츠 유형 확인
- 동시 처리 수와 instance memory의 관계
- subprocess timeout과 종료
- 성공·실패·client disconnect 뒤 임시 파일 정리
- 결과가 큰 경우 response 대신 임시 GCS 사용
컨테이너 image 크기는 Cloud Run instance에 할당된 실행 memory를 줄이지 않지만, 런타임이 읽고 쓰는 파일과 추가 process는 memory limit 안에 들어간다.
분리만으로 안전해지지는 않는다
converter를 별도 서비스로 만들면 blast radius와 권한 경계는 생긴다. 하지만 각 서비스의 입력 검증이 자동으로 동일해지는 것은 아니다. 오래된 변환기에는 확장자 검사, MIME 확인, subprocess 실행 방식과 cleanup 수준이 서로 다를 수 있다.
그래서 공통 계약을 별도로 검토한다.
- 외부 파일명을 shell command 문자열에 직접 넣지 않는다.
- 가능한 경우
execFile처럼 인자를 분리해 실행한다. - LaTeX처럼 본질적으로 code compile에 가까운 입력은 별도 제한과 격리를 둔다.
- 오류 응답에 문서 원문이나 compiler log 전체를 노출하지 않는다.
- 변환 완료 뒤 원본과 중간 파일이 남지 않는지 테스트한다.
서비스 분리는 보안 개선을 적용할 위치를 만들어 줄 뿐, 검증 자체를 대신하지 않는다.
운영 측면의 트레이드오프
장점은 명확했다.
- 형식별 dependency와 취약점 소유권이 분리된다.
- resource와 timeout을 독립적으로 조정한다.
- 사용하지 않는 converter를 배포하거나 권한 부여하지 않아도 된다.
- 변환기 장애가 메인 API의 생존성과 분리된다.
대신 service 수, build script, IAM binding과 관측 지점이 늘어난다. 동기 호출 chain이 길어지면 timeout과 retry를 두 계층에서 맞춰야 한다. 작은 팀에서는 converter가 정말 다른 failure domain인지 확인하지 않고 무조건 microservice로 나누면 운영 부담만 커질 수 있다.
지금 다시 한다면
형식별 구현 전에 공통 converter contract를 먼저 만들 것이다. 입력 한도, 인증, timeout, 취소, 임시 파일, 오류 shape와 idempotency를 고정하고 각 runtime adapter만 다르게 구현한다.
큰 변환은 동기 HTTP response로 돌려주기보다 작업 ID를 반환하고 GCS에 점진 저장하는 구조도 검토할 것이다. 긴 문서는 연결 하나의 수명보다 작업 상태의 수명이 길기 때문이다.
핵심은 Cloud Run 서비스를 많이 만드는 것이 아니다. 무거운 native dependency와 불신 파일 처리를 메인 서비스에서 격리하고, 형식별 resource·실패·보안 계약을 독립적으로 운영하는 것이다.