PDF 테이블 추출기는 작은 문서에서는 별문제 없이 동작했다. 그런데 수백 페이지 문서를 1GiB 메모리의 Cloud Run 서비스에 넣자 처리 도중 503이 발생했다. 같은 입력을 다시 시도하면 이번에는 300초 부근에서 504가 났다.
처음에는 메모리와 timeout을 각각 늘리면 될 것처럼 보였다. 실제 원인은 하나의 입력을 처리하는 방식, Cloud Run의 메모리 모델, 서버와 호출자의 시간 제한이 서로 맞지 않았다는 데 있었다.
전체 PDF 처리는 peak를 한곳에 모은다
테이블 파서는 PDF 본문만 메모리에 올리지 않는다. 페이지 구조, 글자 위치, 선분, 데이터프레임과 변환 중간 객체도 함께 만든다. 결과를 임시 파일로 쓰더라도 Cloud Run 컨테이너의 writable filesystem은 메모리를 사용한다. 따라서 파일 크기만 보고 필요한 메모리를 계산하면 실제 peak를 과소평가하기 쉽다.
초기 구현은 PDF 전체 페이지를 한 번에 parser에 넘겼다. 처리 중 생성된 객체는 마지막까지 남기 쉬웠고, 실패하면 완료된 앞부분까지 다시 계산해야 했다.
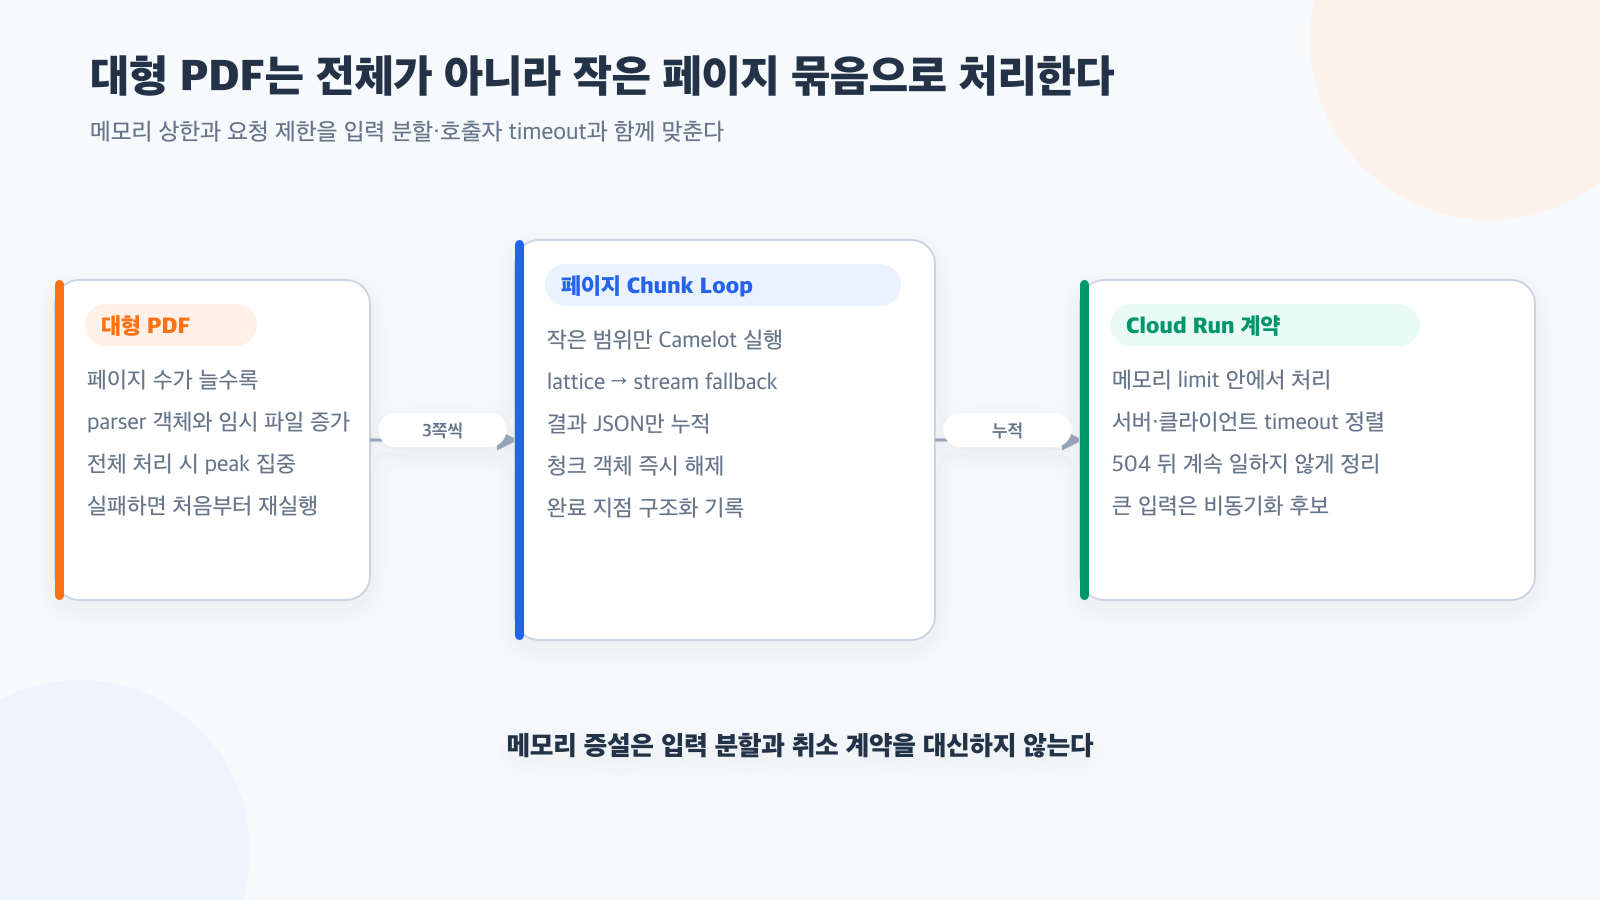
우리는 입력을 세 페이지 단위로 나눴다.
전체 PDF
  → 1~3페이지 추출
  → 결과 JSON에 누적
  → 청크 객체 해제
  → 4~6페이지 추출
  → 반복
각 청크에서는 격자선 기반 추출을 먼저 시도하고, 결과가 없으면 텍스트 위치 기반 추출로 전환했다. 처리한 객체는 다음 청크로 넘어가기 전에 참조를 끊었다. 이 방식은 전체 계산량을 없애지는 않지만 동시에 살아 있는 작업 집합을 줄인다.
메모리 증설만 선택하지 않은 이유
메모리를 늘리는 것은 유효한 응급조치다. 그러나 입력 크기가 계속 커질 수 있다면 다음 문서에서 같은 문제가 다시 나타난다. 동시 요청이 둘 이상 들어올 때 instance 메모리 사용량도 함께 늘어난다.
입력 분할은 다른 이점도 있었다.
- 어느 페이지 범위까지 완료됐는지 기록할 수 있다.
- 특정 페이지의 parser 실패를 전체 파일 실패와 구분할 수 있다.
- 향후 청크 결과를 점진 저장하거나 비동기 작업으로 옮길 경계가 생긴다.
- 페이지별 처리시간을 이용해 큰 입력의 예상 시간을 계산할 수 있다.
다만 청크를 작게 나눈다고 항상 빠른 것은 아니다. parser 초기화 횟수와 garbage collection이 늘 수 있다. 청크 크기는 처리량보다 peak memory와 실패 복구 단위를 먼저 보고 정해야 한다.
서버와 호출자의 timeout을 함께 맞춘다
메모리 문제를 줄인 뒤에는 300초 제한이 다음 병목이 됐다. 서버의 Cloud Run request timeout과 호출자의 AbortController가 같은 경계에서 요청을 끊었다. 큰 문서는 거의 완료된 상태에서도 504가 날 수 있었다.
현재 처리 경로는 서버, 애플리케이션 서버와 호출자의 제한을 600초로 맞춘다. 중요한 것은 600이라는 숫자가 아니라 가장 짧은 timeout이 전체 요청의 실제 상한이 된다는 점이다.
Cloud Run request timeout
애플리케이션 서버 timeout
호출자 fetch timeout

→ 셋 중 가장 짧은 값이 실제 완료 가능 시간을 결정
Cloud Run은 request timeout이 지나면 504를 반환하지만 그 요청을 처리하던 container instance 자체를 종료하지는 않는다. 애플리케이션 코드가 취소를 인지하지 못하면 응답할 곳이 사라진 뒤에도 CPU와 메모리를 사용할 수 있다. 그래서 긴 timeout을 허용할수록 남은 시간 확인, 취소 전파와 임시 파일 정리가 더 중요해진다.
fallback도 비용과 품질의 일부다
전처리기가 실패하면 원본 PDF를 다음 AI 단계에 바로 넘기는 fallback이 있었다. 이 덕분에 작업 자체는 계속될 수 있었지만, 큰 원본이 모델 입력으로 들어가 토큰 수와 처리시간이 급격히 늘고 테이블 구조화 품질도 달라졌다.
fallback이 존재한다는 사실만으로 안정적이라고 볼 수 없다. 다음을 함께 관측해야 한다.
- 전체 페이지 수와 완료 페이지 범위
- 청크별 처리시간과 추출 방식
- timeout 당시 마지막 완료 지점
- fallback 진입 횟수와 후속 입력 크기
- instance 종료, 503과 504의 구분
지금 다시 한다면
처음부터 페이지 수를 읽은 뒤 예상 청크 수와 시간 budget을 계산할 것이다. 짧은 문서는 동기 HTTP로 처리하고, 제한을 넘을 가능성이 높은 문서는 비동기 작업으로 접수해 청크 결과를 점진 저장하는 구조를 선택할 것이다.
테스트도 작은 정상 PDF 하나로 끝내지 않는다. 페이지 수와 테이블 밀도가 다른 합성 문서를 준비해 memory peak, 처리시간, fallback 결과와 임시 파일 정리를 함께 본다.
이 사례의 핵심은 Cloud Run 메모리를 크게 잡는 법이 아니다. 입력 전체를 한 번에 소유하지 않고, 메모리·시간·재시도 단위를 같은 청크 경계로 맞추는 것이다.