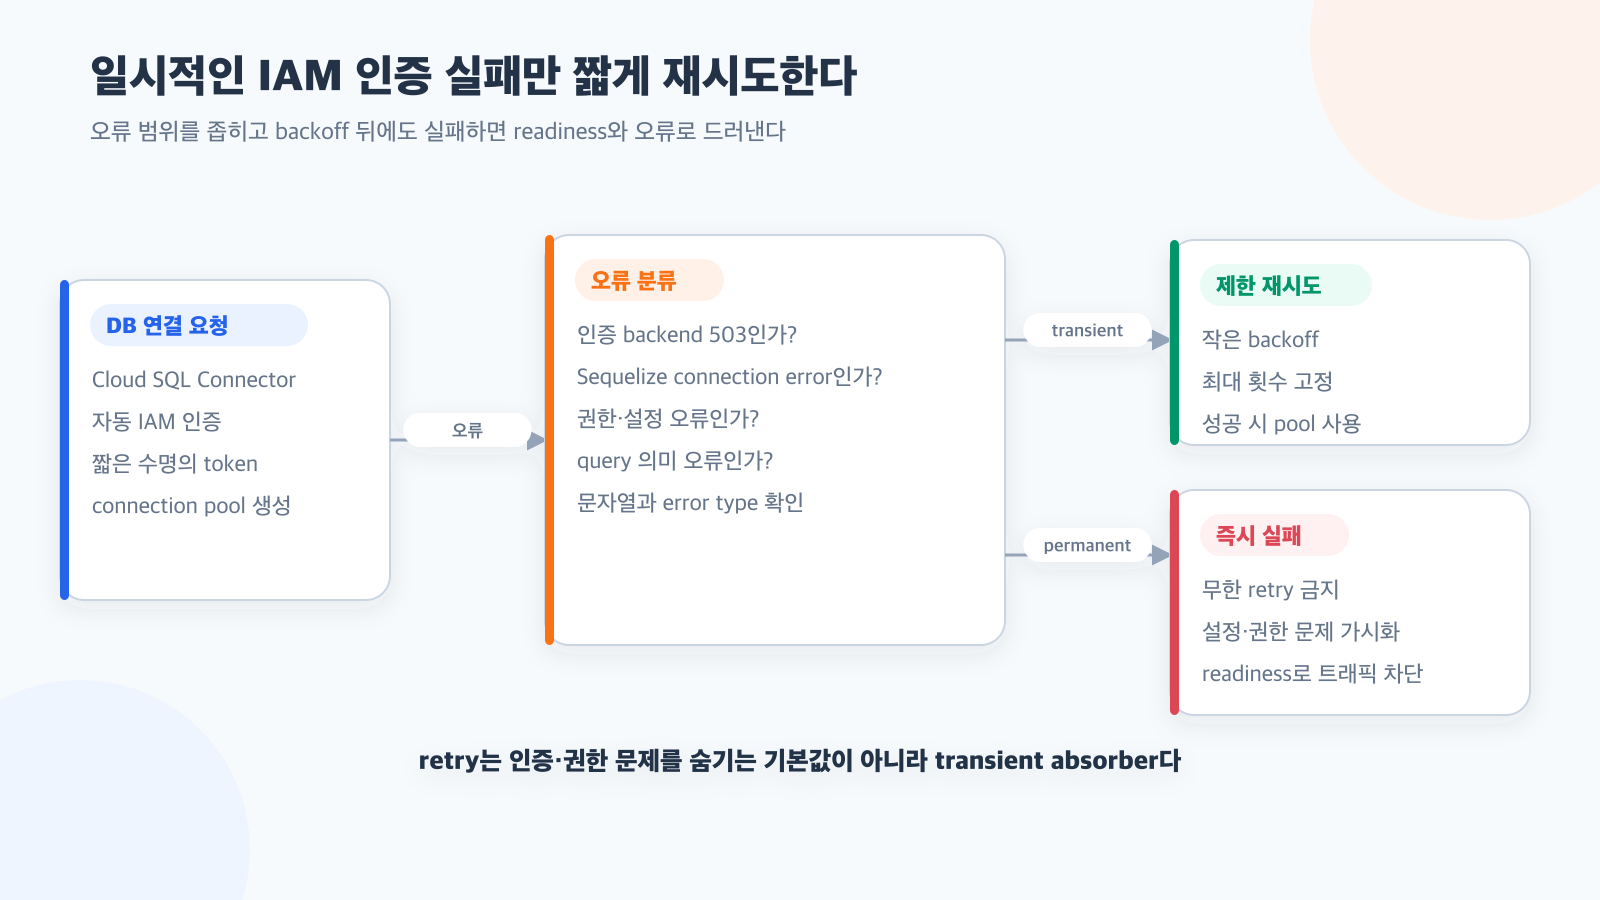
Cloud SQL 비밀번호를 애플리케이션에 저장하는 대신 Node.js Connector와 IAM 데이터베이스 인증을 사용했다. 평소에는 안정적이었지만 어느 요청에서 access token을 가져오는 upstream이 503을 반환했고, 새 DB 연결이 실패하면서 위젯 요청도 500으로 끝났다.
권한이 틀린 것도, PostgreSQL이 내려간 것도 아니었다. 잠깐 뒤 같은 연결은 성공할 수 있는 일시 오류였다. 그렇다고 모든 DB 오류를 재시도하면 설정 문제와 잘못된 query를 늦게 발견하게 된다.
자동 IAM 인증에도 외부 의존성이 있다
Cloud SQL Connector는 IAM 권한 확인, 암호화 연결과 자동 token 처리를 맡는다. 장기 실행 프로세스가 짧은 수명의 access token을 직접 갱신하지 않아도 되는 장점이 있다.
하지만 연결 생성 경로에는 여전히 여러 의존성이 있다.
애플리케이션
  → Cloud SQL Connector
  → IAM access token
  → Cloud SQL 연결
  → PostgreSQL 인증
  → connection pool
이 중 token API나 관리 계층의 짧은 장애는 database row나 query와 무관하다. 기존 pool connection이 살아 있으면 요청이 정상이고, 새 connection이 필요한 순간에만 실패가 드러날 수도 있다.
retry 대상을 좁게 정의한다
우리는 Sequelize의 retry 조건에 다음 범주만 넣었다.
- Sequelize connection 계열 오류
- Cloud SQL IAM 인증 실패로 식별되는 오류
- token fetch의 HTTP 503 패턴
재시도는 두 번의 짧은 backoff로 제한했다. 목적은 장기 장애를 감추는 것이 아니라 순간적인 control-plane 흔들림을 요청 한 번 안에서 흡수하는 것이다.
다음 오류는 같은 정책으로 재시도하지 않는다.
- IAM role 또는 database user가 잘못된 권한 오류
- instance connection name과 network 설정 오류
- 존재하지 않는 table이나 column을 조회한 query 오류
- constraint, schema 또는 payload 오류
- application transaction 안의 도메인 실패
재시도 가능 여부는 메시지 문자열 하나만으로 결정하지 않는다. SDK의 error type과 알려진 status를 함께 보고, 모르는 오류는 안전하게 실패시킨다.
backoff는 짧아도 필요하다
즉시 같은 요청을 반복하면 동일한 장애 구간에 다시 부딪힐 가능성이 높다. 여러 Pod가 동시에 새 connection을 만들면 인증 API와 DB에 더 큰 부하를 줄 수도 있다.
짧은 exponential backoff는 재시도 사이에 회복할 시간을 준다. 다만 delay와 횟수를 크게 잡으면 사용자는 오래 기다린 뒤 결국 같은 오류를 받는다. HTTP 요청 경로에서는 전체 latency budget 안에 들어오는 작은 retry만 허용하고, 장기 복구는 readiness와 rollout 정책에 맡긴다.
시작 성공과 요청 성공을 구분한다
DB 초기화 과정에서 authenticate()가 실패했는데 오류를 로그만 남기고 애플리케이션을 Ready로 만들면 트래픽이 들어온 뒤 반복해서 500이 난다. 반대로 단 한 번의 503으로 process를 영구 종료하면 일시 장애가 전체 Pod 교체로 확대된다.
권장 경계는 다음과 같다.
- 초기 connection은 제한 재시도한다.
- 끝까지 실패하면 startup 또는 readiness를 실패로 표시한다.
- 살아 있는 pool의 일시적인 새 connection 실패는 요청 범위 retry로 흡수한다.
- 지속 실패는 health와 오류율로 드러내고 무한 loop를 만들지 않는다.
현재 적용한 핵심 수정은 Sequelize 연결 계층의 제한 retry다. readiness까지 포함한 전체 부팅 계약은 별도의 검증 대상이다. retry 설정 하나만으로 “서비스가 항상 살아남는다”고 표현하면 실제 보장보다 강하다.
관측할 것은 오류 건수만이 아니다
같은 503도 한 Pod에서 한 번 발생한 것과 전체 Pod에서 몇 분간 지속된 것은 의미가 다르다. 다음 지표를 함께 본다.
- 최초 연결과 pool 확장 중 어느 단계에서 실패했는가
- 첫 시도 실패 후 retry로 복구된 횟수
- 최대 retry를 소진한 요청 수
- connection pool 대기시간과 사용 중 connection 수
- readiness 실패와 사용자 5xx의 시간 관계
로그에는 token이나 connection secret을 남기지 않는다. 오류 종류, attempt, 지연과 service stage만으로 진단할 수 있어야 한다.
지금 다시 한다면
Connector와 ORM을 감싼 작은 connection factory를 두고, transient 분류와 retry budget을 단위 테스트할 것이다. 가짜 connector가 첫 시도에 503, 두 번째에 성공하도록 해 pool이 하나만 생성되는지 확인한다. 권한 오류는 한 번만 실행되고 즉시 실패하는지도 고정한다.
핵심은 DB 연결에 retry를 켜는 것이 아니다. 미래의 재시도로 결과가 달라질 수 있는 오류만 제한적으로 흡수하고, 권한·설정·schema 오류는 빠르게 드러내는 것이다.