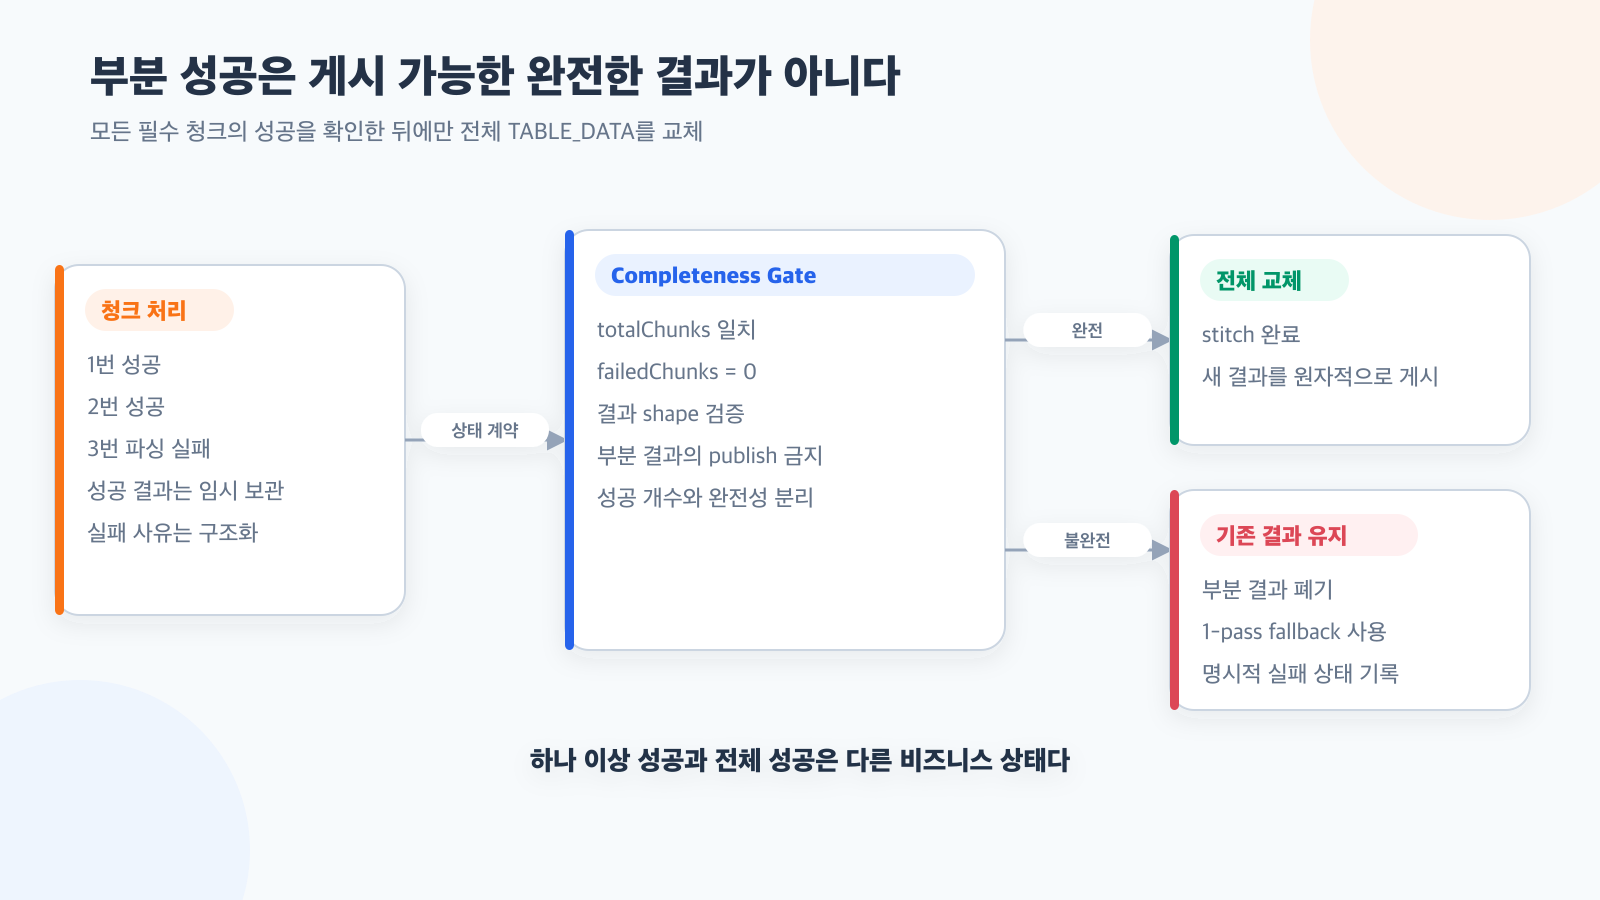
대형 PDF 테이블을 여러 청크로 나누어 AI로 정리하면 각 호출은 독립적으로 성공하거나 실패할 수 있다. 어느 날 세 청크 중 하나만 정상 JSON으로 돌아왔고 두 청크는 구조 검증에 실패했다. 작업의 최종 상태는 성공이었다.
더 위험한 점은 오류가 크게 보이지 않았다는 것이다. 성공한 한 청크의 결과가 문서 전체 테이블인 것처럼 기존 데이터를 교체할 수 있었다. 명시적인 500 오류보다 발견하기 어려운 조용한 데이터 손실이었다.
continue는 오류 처리가 아니라 정책이다
기존 반복문은 청크 응답을 JSON으로 파싱하지 못하면 로그를 남기고 continue했다. 다음 청크는 계속 처리됐고, 하나 이상의 결과가 있으면 성공 결과들을 합쳐 반환했다.
for (const chunk of chunks) {
    const parsed = parse(chunk);
    if (!parsed) continue;
    results.push(parsed);
}

return merge(results);
문법상 자연스러운 코드지만 비즈니스 의미는 강하다. “이 청크가 없어도 전체 결과를 게시해도 된다”는 정책을 암묵적으로 선택한다. 테이블의 모든 행이 필요한 작업에서는 성립하지 않는 가정이었다.
성공 개수와 완전성을 분리한다
우리는 반환값을 테이블 객체 하나에서 처리 상태를 포함한 계약으로 바꿨다. 핵심 값은 다음과 같다.
- 전체 청크 수
- 성공한 청크 수
- 청크별
SUCCEEDED또는FAILED - 실패 청크 번호와 구조화된 이유
- 전체 결과를 게시할 수 있는지 나타내는 최종 상태
- fallback을 선택한 이유
모든 필수 청크가 성공한 경우에만 COMPLETED와 합쳐진 table을 반환한다. 하나라도 실패하면 성공한 부분 결과가 있더라도 table은 반환하지 않고 FALLBACK으로 끝낸다.
성공 3 / 전체 3 → stitch → 전체 결과 교체
성공 1 / 전체 3 → 부분 결과 폐기 → 기존 1-pass 결과 유지
성공 0 / 전체 3 → 전체 실패 → 기존 1-pass 결과 유지
부분 결과를 버리는 것이 아깝게 보일 수 있다. 그러나 부분 결과를 전체로 게시하면 누락된 행을 복구할 근거가 사라진다. 임시 진단용으로 보관하는 것과 사용자에게 완전한 결과로 제공하는 것은 다른 결정이다.
파서는 작은 계약만 책임진다
응답 parser는 모델 출력이 객체인지, data가 배열인지처럼 최소 shape만 검증한다. 청크 전체의 완전성과 fallback 정책까지 parser 안에 넣지 않았다.
역할을 나누면 실패 위치가 선명해진다.
- parser: 단일 응답이 최소 JSON 계약을 만족하는가
- chunk runner: 각 호출의 성공·실패 상태는 무엇인가
- completeness gate: 모든 필수 청크가 준비됐는가
- publisher: 완전한 결과만 기존 전체 데이터를 교체하는가
파싱 실패 때 모델 응답 원문을 그대로 로그에 남기지 않는 것도 중요하다. 고객 문서가 오류 메시지에 복제될 수 있기 때문이다. 로그에는 청크 번호, 실패 단계와 계약 위반 종류만 남겼다.
보완 호출은 필수 청크 실패와 다르다
한 청크의 1차 결과가 유효하지만 누락이 의심될 때는 보완 호출을 실행한다. 보완 응답이 실패하면 유효한 1차 결과를 유지할 수 있다. 반대로 1차 필수 응답 자체가 파싱되지 않았다면 그 청크는 실패다.
둘을 같은 실패로 취급하면 작은 품질 보완 실패 때문에 전체를 버리게 된다. 반대로 둘을 모두 무시하면 필수 데이터가 없는 결과를 게시한다. required result와 best-effort supplement를 계약에서 나누는 이유다.
테스트는 세 상태를 모두 고정한다
정상 경로 하나만 테스트하면 이번 버그를 잡을 수 없다. 최소한 다음 조합을 독립적으로 검증했다.
- 모든 청크 성공: 상태는
COMPLETED, 전체 결과가 합쳐진다. - 모든 청크 실패: 상태는
FALLBACK, 새 table은 없다. - 일부 청크 실패: 성공 결과가 있어도 상태는
FALLBACK, 새 table은 없다. - 보완 호출 실패: 유효한 1차 결과는 유지된다.
- 취소 요청: 다음 모델 호출과 stitch를 시작하지 않는다.
특히 세 번째 테스트가 회귀 방지의 핵심이다. results.length > 0이 성공 조건으로 다시 들어오면 즉시 실패해야 한다.
지금 다시 한다면
병렬·분할 작업을 설계할 때부터 aggregate 결과에 completeness를 1급 상태로 넣을 것이다. 처리율 화면에서도 성공 청크 수와 게시 가능한 작업 수를 따로 보여줄 것이다.
업무에 따라 부분 성공을 허용할 수도 있다. 예를 들어 독립된 이미지 썸네일은 성공한 것만 게시해도 괜찮을 수 있다. 그러나 원본 전체를 대표하는 테이블·원장·색인이라면 atomic publish가 기본이어야 한다.
핵심은 재시도를 몇 번 할지가 아니다. 부분 성공을 사용자에게 제공할 수 있는 도메인인지 먼저 정하고, 완전성 조건을 코드의 반환 타입과 게시 경계에 명시하는 것이다.
Cloudturing에서는
Cloudturing은 일부 페이지만 분석된 결과가 원본 문서 전체를 대신하지 않도록 문서 학습 과정에 완전성 검사를 적용하고 있다. 모든 필수 청크가 성공한 뒤에만 새로운 결과를 게시하고, 결과가 불완전하면 기존 데이터를 보존한다.