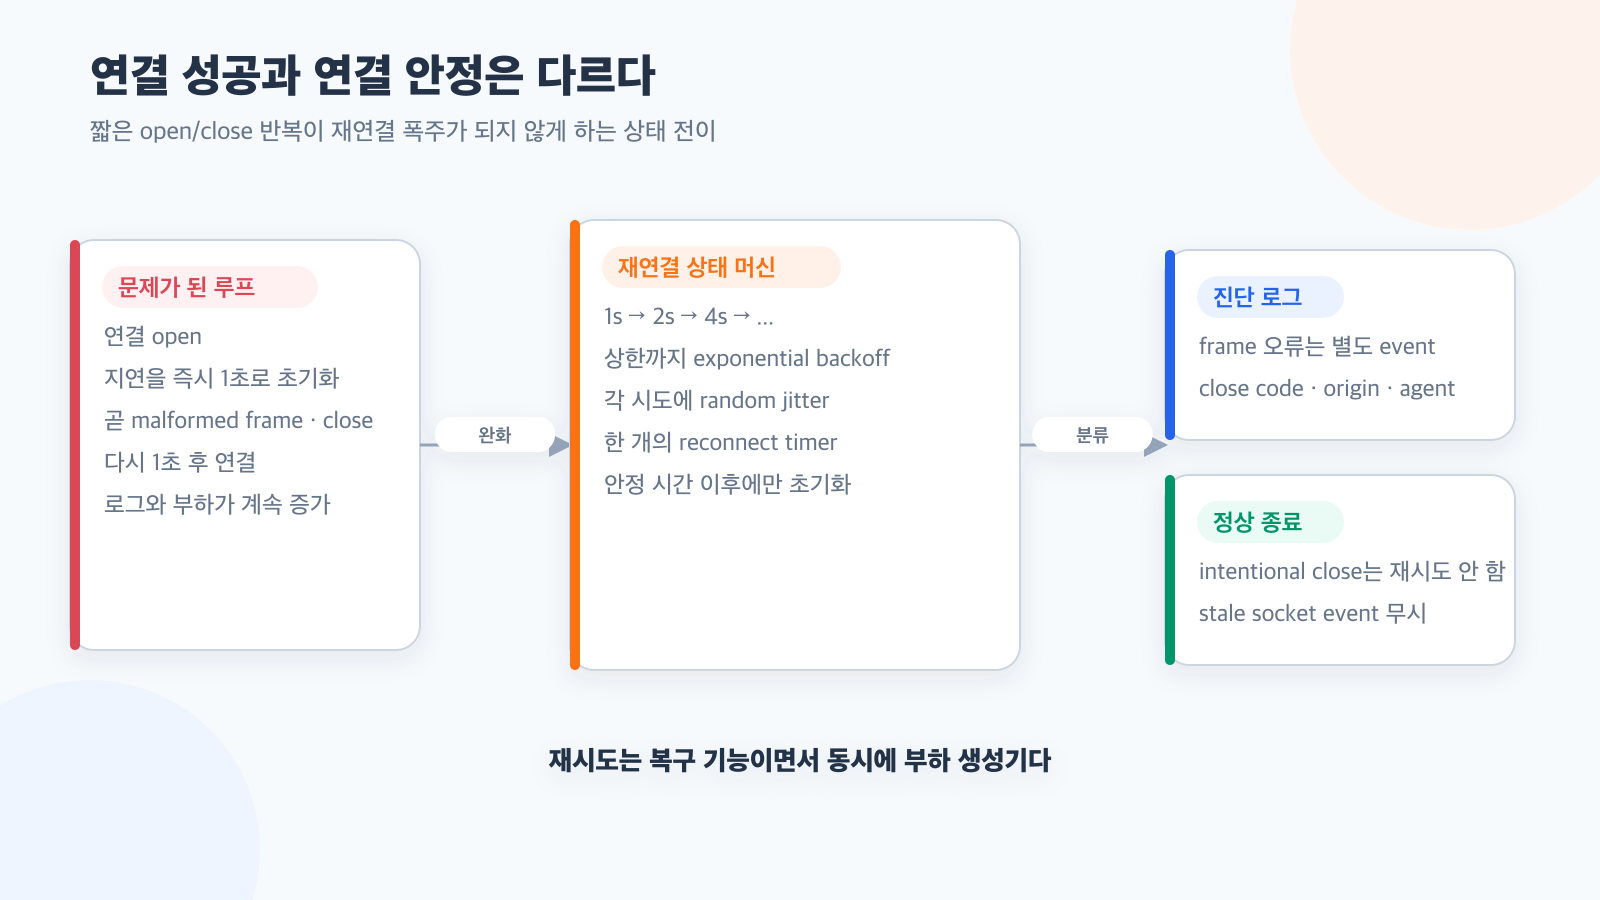
3줄 요약
- 일부 client가 연결 직후 malformed frame으로 닫히고 다시 연결하면서 서비스 장애보다 로그·알림과 연결 부하를 더 크게 만들었다.
- WebSocket이 잠깐 open됐다는 이유로 backoff를 초기화하지 않고, 일정 시간 안정적으로 유지된 뒤에만 초기 지연으로 되돌렸다.
- exponential backoff, jitter, 단일 timer와 오류 분류를 함께 적용해 재연결을 복구 기능이면서도 통제된 부하로 만들었다.
증상: 서버는 살아 있는데 오류가 반복됐다
Gateway process와 정상 사용자의 대화는 계속 동작하고 있었다. 그런데 운영 로그에는 Invalid WebSocket frame 계열 오류와 짧은 연결 종료가 반복해서 나타났다. 같은 client 특성의 연결이 생성되고 곧 닫힌 뒤 다시 나타나는 패턴이었다.
이런 로그를 모두 server error로 분류하면 실제 서비스 장애처럼 보인다. 알림이 반복되고 중요한 Engine 오류가 묻힌다. 동시에 client가 즉시 재접속하면 load balancer, Gateway의 handshake와 인증 경로에 불필요한 부하를 만든다.
문제는 malformed frame 한 건이 아니라 실패 뒤 행동이었다.
기존 backoff가 사실상 동작하지 않은 이유
Client에는 지수 backoff가 이미 있었다. 연결 실패 때 1초, 2초, 4초처럼 지연을 늘리고 상한을 두는 구조였다. 하지만 onopen이 실행되는 순간 지연을 다시 초기값으로 돌렸다.
TCP와 WebSocket handshake가 완료돼 open이 발생한 직후 잘못된 frame이나 protocol mismatch로 연결이 닫힐 수 있다. 이 경우 매번 open에는 성공하므로 backoff는 계속 1초로 초기화된다.
open → backoff 1초로 초기화 → 즉시 close
→ 1초 후 reconnect → open → 다시 초기화 → close
코드에는 exponential backoff가 있었지만 장애 패턴에서는 항상 첫 단계만 사용했다. 연결 성공과 연결 안정성을 같은 상태로 취급한 것이 원인이었다.
안정 연결 시간을 별도 상태로 두었다
onopen에서는 backoff를 즉시 초기화하지 않고 안정화 timer를 시작했다. 소켓이 일정 시간 계속 현재 소켓이며 OPEN 상태일 때만 지연을 초기값으로 되돌린다. 그 전에 닫히면 지금까지 증가한 backoff를 유지한다.
이때 오래된 socket의 timer가 새 socket 상태를 덮어쓰지 않도록 currentSocket identity도 비교했다. 빠른 재연결에서는 이전 연결의 늦은 event와 timer가 새 연결 객체에 도착할 수 있기 때문이다.
연결이 닫힐 때는 안정화 timer를 지우고, 사용자가 의도적으로 닫은 경우가 아니라면 재연결을 예약한다. 새 세션 시작처럼 의도된 재연결은 자동 복구 loop와 별도 흐름으로 처리했다.
Jitter가 필요한 이유
지수 backoff만 사용하면 같은 시점에 끊긴 많은 client가 똑같이 1초, 2초, 4초 뒤에 다시 접속한다. 트래픽이 톱니 모양의 큰 spike로 모인다. 각 지연에 작은 random jitter를 더해 시도를 시간축에 분산했다.
delay = exponentialDelay + randomJitter
next  = min(exponentialDelay × 2, maxDelay)
상한도 필요하다. 무한히 길어지면 네트워크가 복구된 뒤 사용자가 너무 오래 기다린다. 반대로 상한이 너무 짧으면 장기 장애 동안 계속 높은 연결 부하를 만든다. 당시 위젯은 초 단위에서 시작해 수십 초 안의 상한을 사용했고, 제품의 실시간 기대와 서버 보호 사이에서 선택했다.
재연결 timer는 하나만 소유한다
error, close, send 실패가 거의 동시에 재연결을 예약할 수 있다. 각 event가 timer를 만들면 한 client가 여러 socket을 동시에 생성한다. 재연결 상태 객체가 timer 하나만 소유하고 이미 예약돼 있으면 추가 예약을 만들지 않게 했다.
disconnect에서는 intentional flag를 먼저 세우고 timer를 취소한다. 화면이 사라졌거나 사용자가 위젯을 닫았는데 자동 재연결이 살아 있으면 메모리와 네트워크가 계속 사용된다.
오류 심각도를 나눴다
malformed frame은 무시할 사건이 아니지만 process 자체의 장애와도 다르다. 알려진 frame parse 오류는 별도 event label을 가진 WARNING으로 낮추고, 그 외 예상하지 못한 socket 오류는 ERROR로 유지했다.
진단에는 close code, 제한된 close reason, origin, user agent와 proxy 경계에서 얻은 연결 정보를 구조화해 남겼다. 원시 frame payload는 기록하지 않았다. 공격 입력이나 개인정보를 로그에 복제하지 않고도 특정 client 계열과 protocol mismatch를 묶을 수 있는 정보만 남겼다.
ERROR 수가 줄었다고 문제가 해결된 것은 아니다. severity 조정은 실제 server failure와 client protocol noise를 분리해 각각의 비율을 보게 하는 작업이다. malformed frame의 빈도와 source 분포는 별도 metric과 WARNING query로 계속 관측해야 한다.
Close code만으로 재시도 결정을 끝내지 않았다
WebSocket close code는 정상 종료, protocol error, server temporary condition 등을 구분하는 단서다. 하지만 browser, proxy와 library를 거치는 동안 기대한 code를 항상 받는다고 가정하기 어렵다. error 뒤 비정상 close가 오거나 reason이 비어 있을 수도 있다.
따라서 정상 종료와 명시적 client 종료는 재시도하지 않는 강한 조건으로 사용하되, 나머지는 안정 시간과 반복 횟수로 완화했다. 인증 실패나 영구적인 정책 거부처럼 재시도로 해결되지 않는 application error는 향후 별도의 retry budget 또는 중단 code로 분리할 수 있다.
검증한 시나리오
단순히 delay 계산 함수만 테스트하지 않았다. socket event 순서를 바꾼 상태 전이를 확인했다.
- open 직후 close가 반복되면 지연이 계속 증가하는가
- 안정 시간 이상 열린 연결만 delay를 초기화하는가
- 이전 socket의 안정화 timer가 새 socket을 초기화하지 않는가
- 여러 close/error event에도 재연결 timer가 하나인가
- intentional close 뒤에는 새 socket이 만들어지지 않는가
- jitter가 상한과 기대 범위를 넘지 않는가
서버 로그에서는 알려진 malformed frame만 WARNING으로 분류되고, close event에 마지막 protocol error가 연결되는지도 확인했다.
지금 다시 한다면
재연결을 독립된 상태 머신으로 명시한다. idle, connecting, probation, stable, backoff, closed 상태와 각 event에서 가능한 전이를 표로 만들 것이다. timer와 socket identity를 상태 안에 두면 stale event 처리가 더 분명해진다.
또한 무한 재시도 대신 시간 구간별 retry budget을 둔다. 일정 횟수 이상 실패하면 사용자에게 새로고침이나 네트워크 확인을 안내하고, 페이지가 background 상태일 때는 더 긴 지연을 적용할 수 있다.
핵심은 backoff 공식을 넣는 것이 아니다. 복구가 확인되기 전에 성공으로 판정해 지연을 초기화하지 않고, 모든 재시도가 서버에 만드는 부하라는 사실을 상태 모델에 반영하는 것이다.
Cloudturing에서는
Cloudturing은 일시적인 네트워크 단절 뒤에도 웹 챗봇 대화를 안정적으로 복구하기 위해 재연결 요청에 backoff 정책을 적용하고 있다. 연결이 일정 시간 안정된 뒤에만 실패 횟수를 초기화하고, 사용자가 종료한 세션은 다시 연결하지 않아 불필요한 서버 부하를 줄인다.