전체 37
#GCP 16
#Node.js 9
#장애 분석 8
#GKE 8
#Kubernetes 7
#보안 6
#Valkey 6
#아키텍처 5
#Cloud Run 5
#회귀 테스트 3
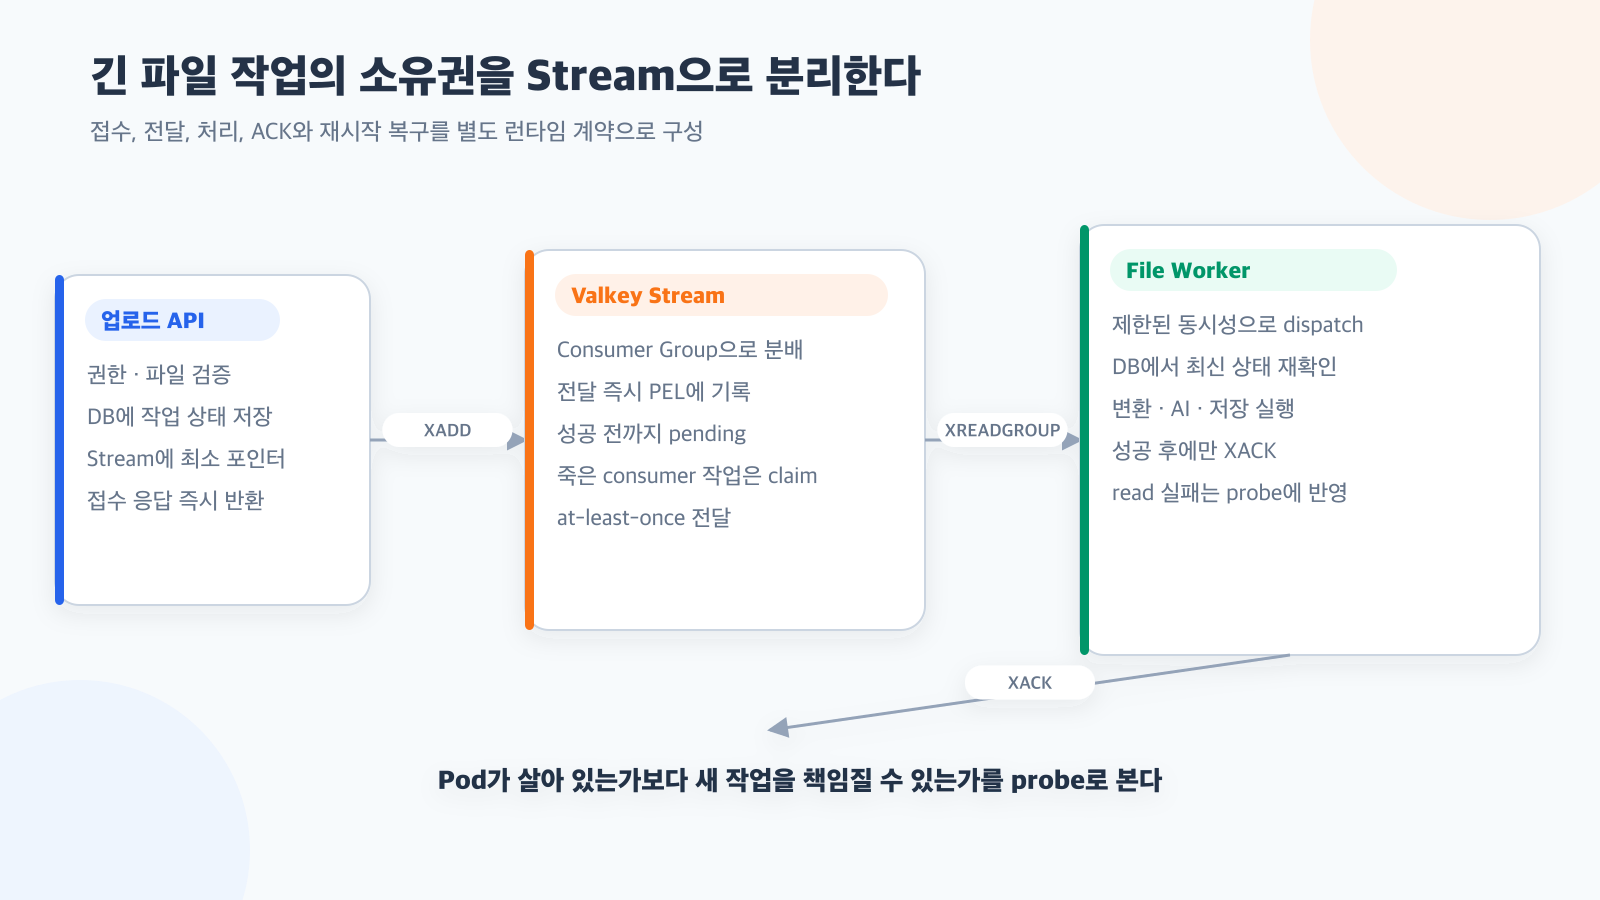
파일 분석을 Valkey Stream Worker로 분리한 이유
업로드 요청과 장기 파일 분석을 Consumer Group, PEL과 성공 후 ACK 계약으로 분리한 비동기 worker 구조를 설명합니다.
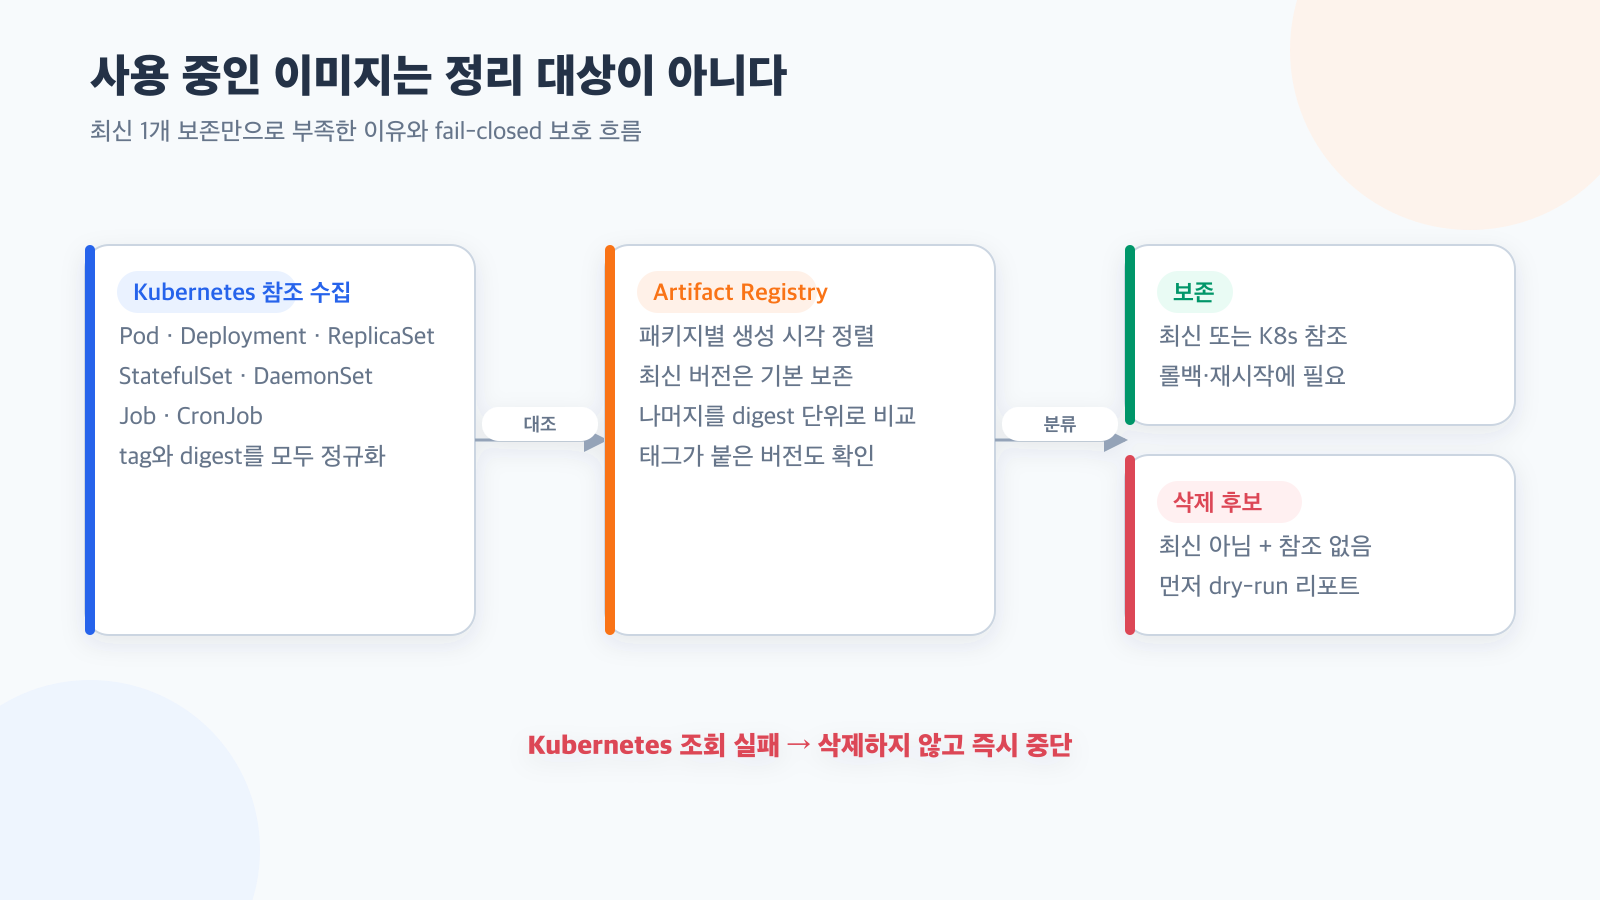
사용 중인 컨테이너 이미지를 지우지 않는 Docker 정리 전략
Artifact Registry 정리 전에 Kubernetes workload가 참조하는 tag와 digest를 보호하고, 조회 실패 시 삭제를 중단하는 fail-closed 운영 패턴을 설명합니다.
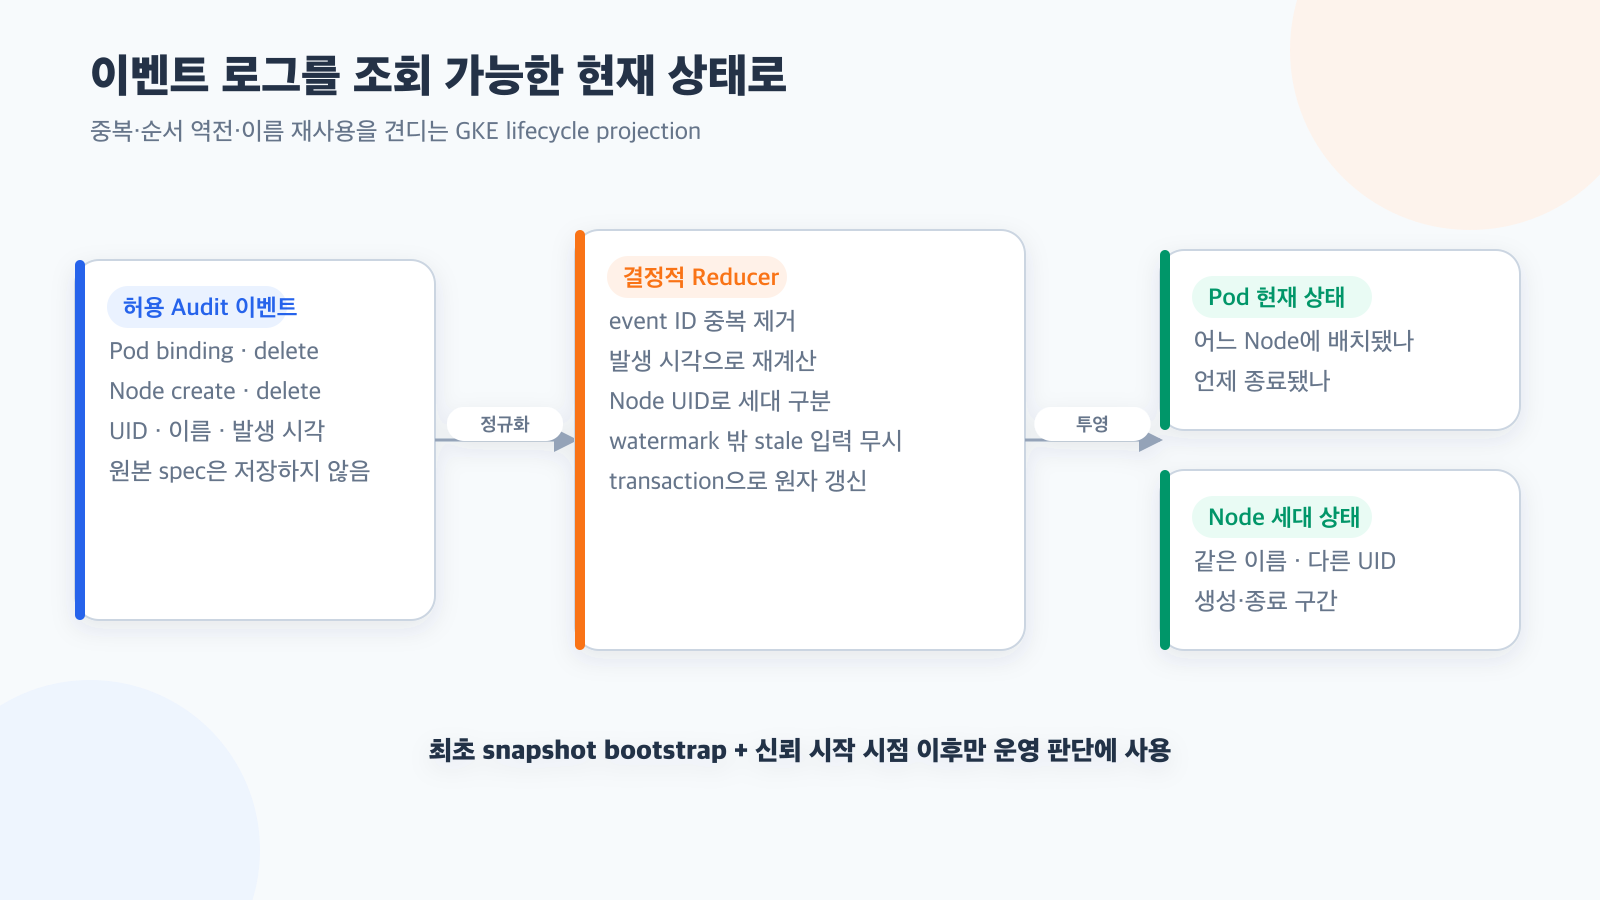
GKE Audit Log를 현재 상태로 투영하는 이벤트 시스템
Pod·Node lifecycle Audit Log를 UID와 발생 시각 기준으로 reduce해 중복, 순서 역전과 이름 재사용을 견디는 현재 상태를 만드는 방법입니다.
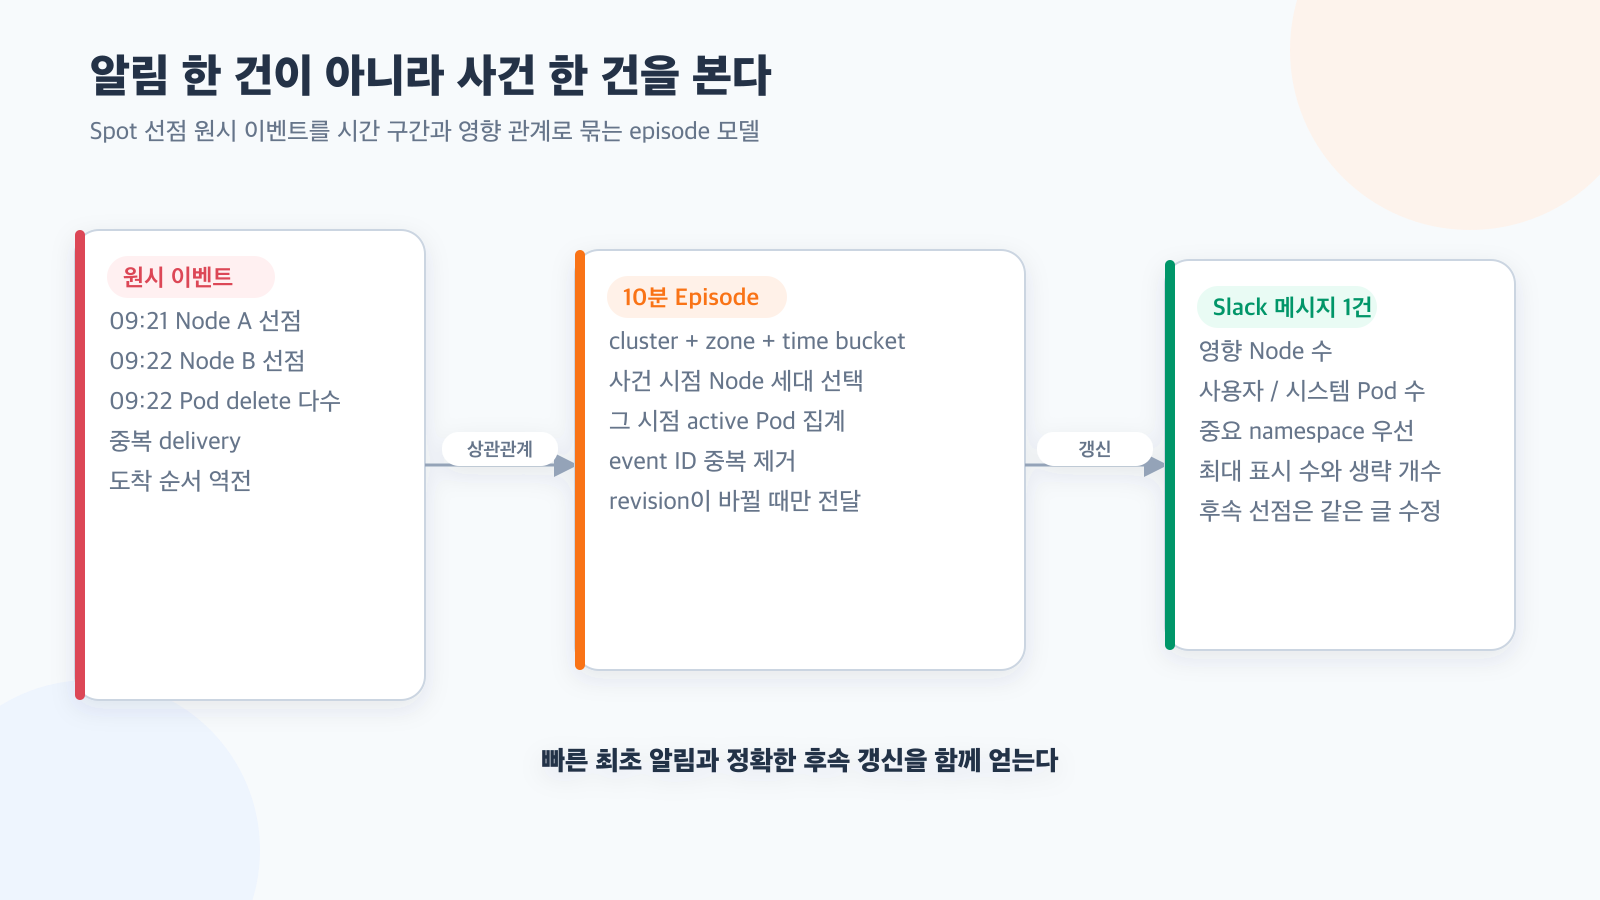
Spot 선점 이벤트를 장애 에피소드로 묶어 알림하기
개별 Spot 선점과 Pod 영향을 시간 구간 episode로 상관 분석하고 Slack 메시지 한 건을 계속 갱신해 알림 소음을 줄인 운영 패턴입니다.
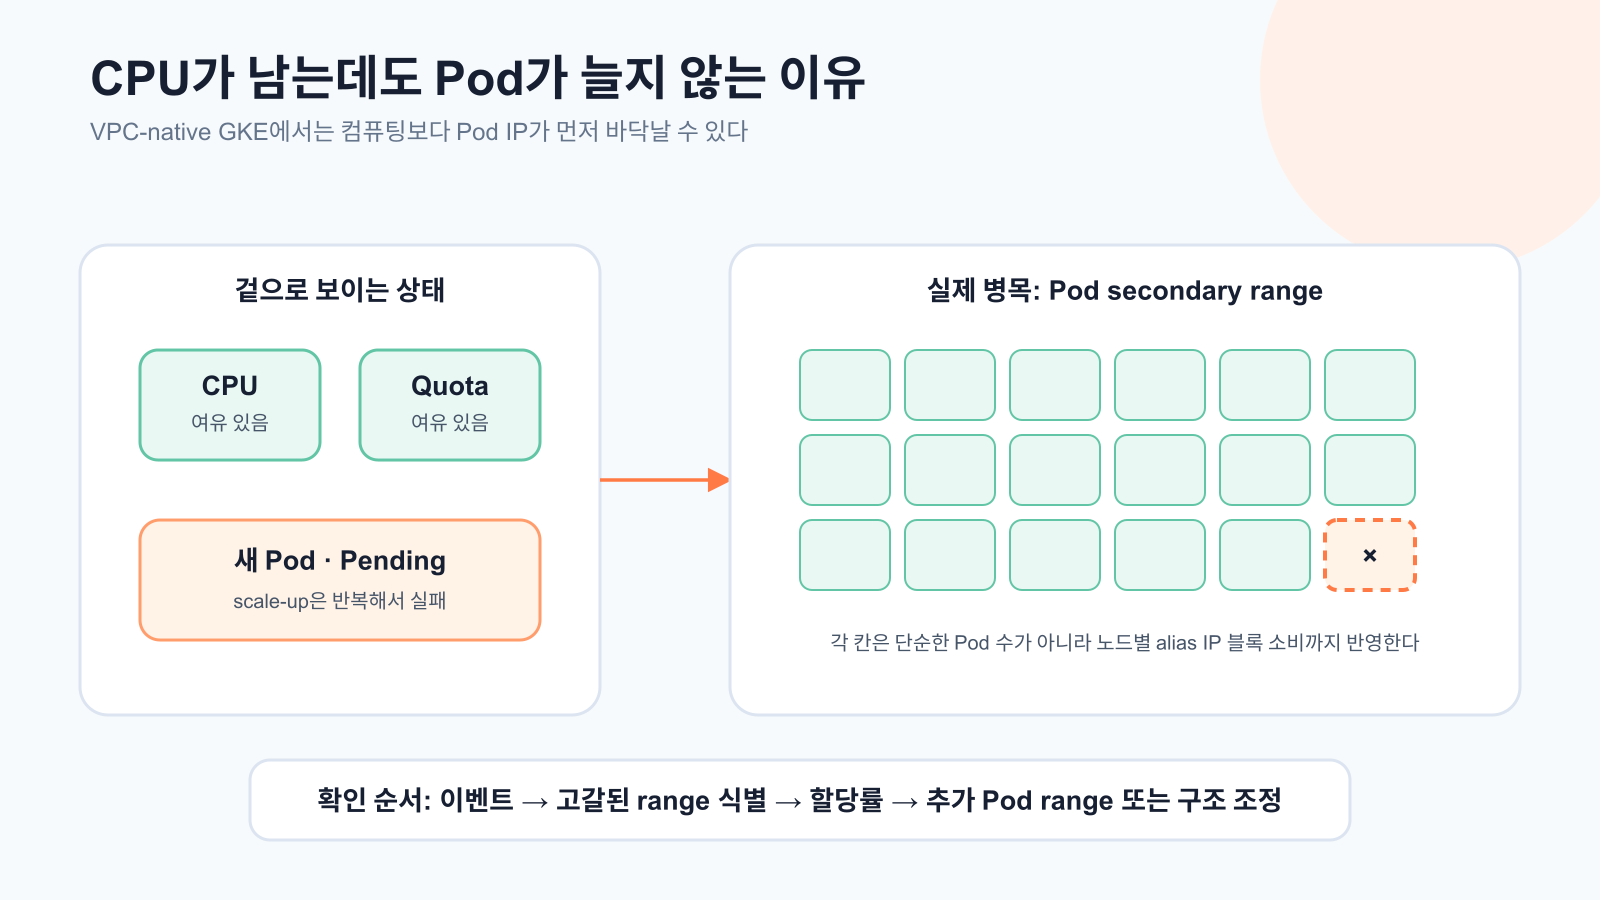
Pod가 안 늘어난 진짜 이유: GKE 보조 IP 대역 고갈
CPU나 quota가 아닌 VPC-native GKE의 Pod secondary range 고갈로 scale-up이 실패한 사례와 진단 순서, 장기 CIDR 계획을 설명합니다.
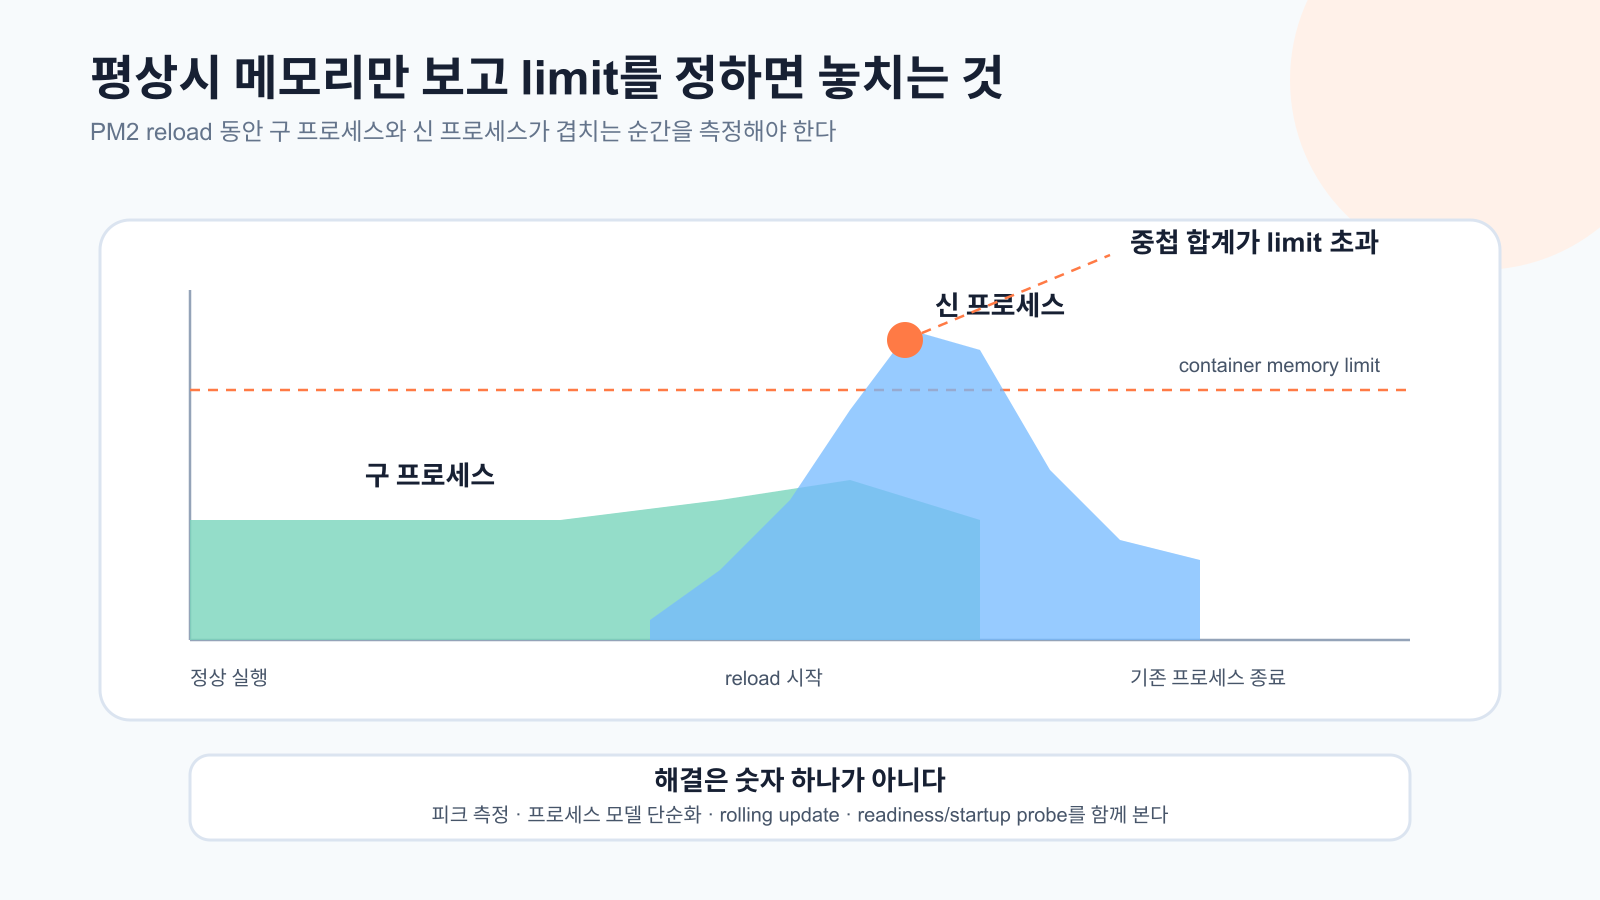
개발 서버에서 PM2 reload가 Pod를 죽였다: 순간 메모리와 OOMKilled
개발 서버에서 빠른 확인을 위해 PM2 reload를 실행하자 구·신 Node.js 프로세스의 메모리가 겹쳐 OOMKilled가 발생한 사례입니다. 운영은 이미지 재배포 방식으로 이 경로를 사용하지 않습니다.
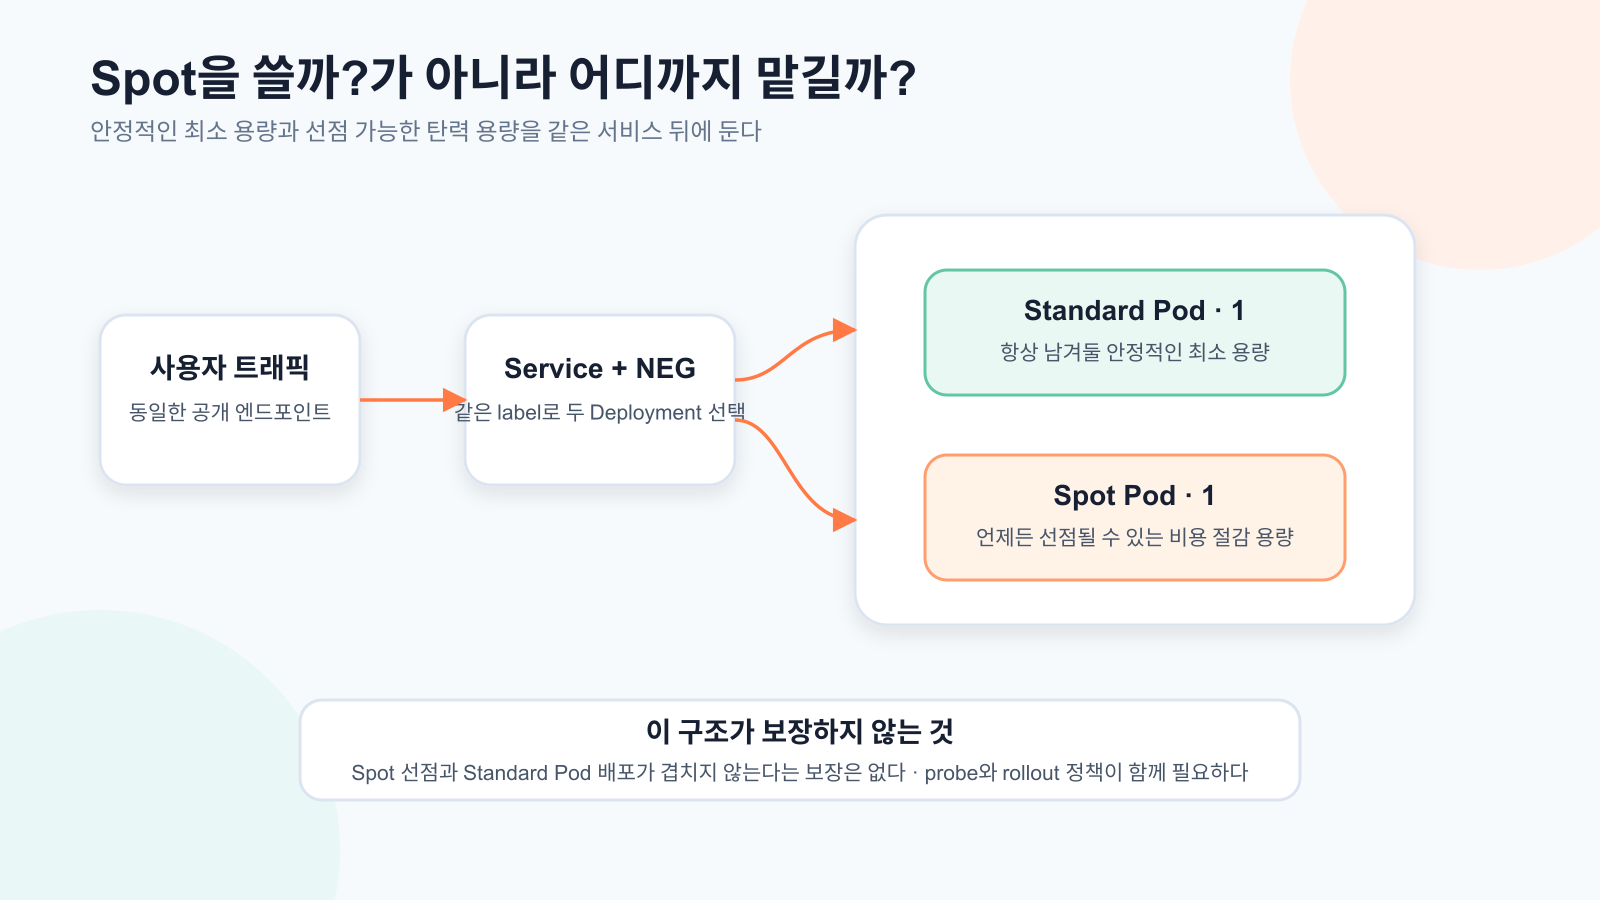
GKE Autopilot에서 Spot과 일반 Pod를 함께 운영한 이유
일반 Pod 하나와 Spot Pod 하나를 같은 Service·NEG에 연결해 안정적인 최소 용량과 비용 효율을 함께 확보한 선택과 운영 조건을 정리합니다.