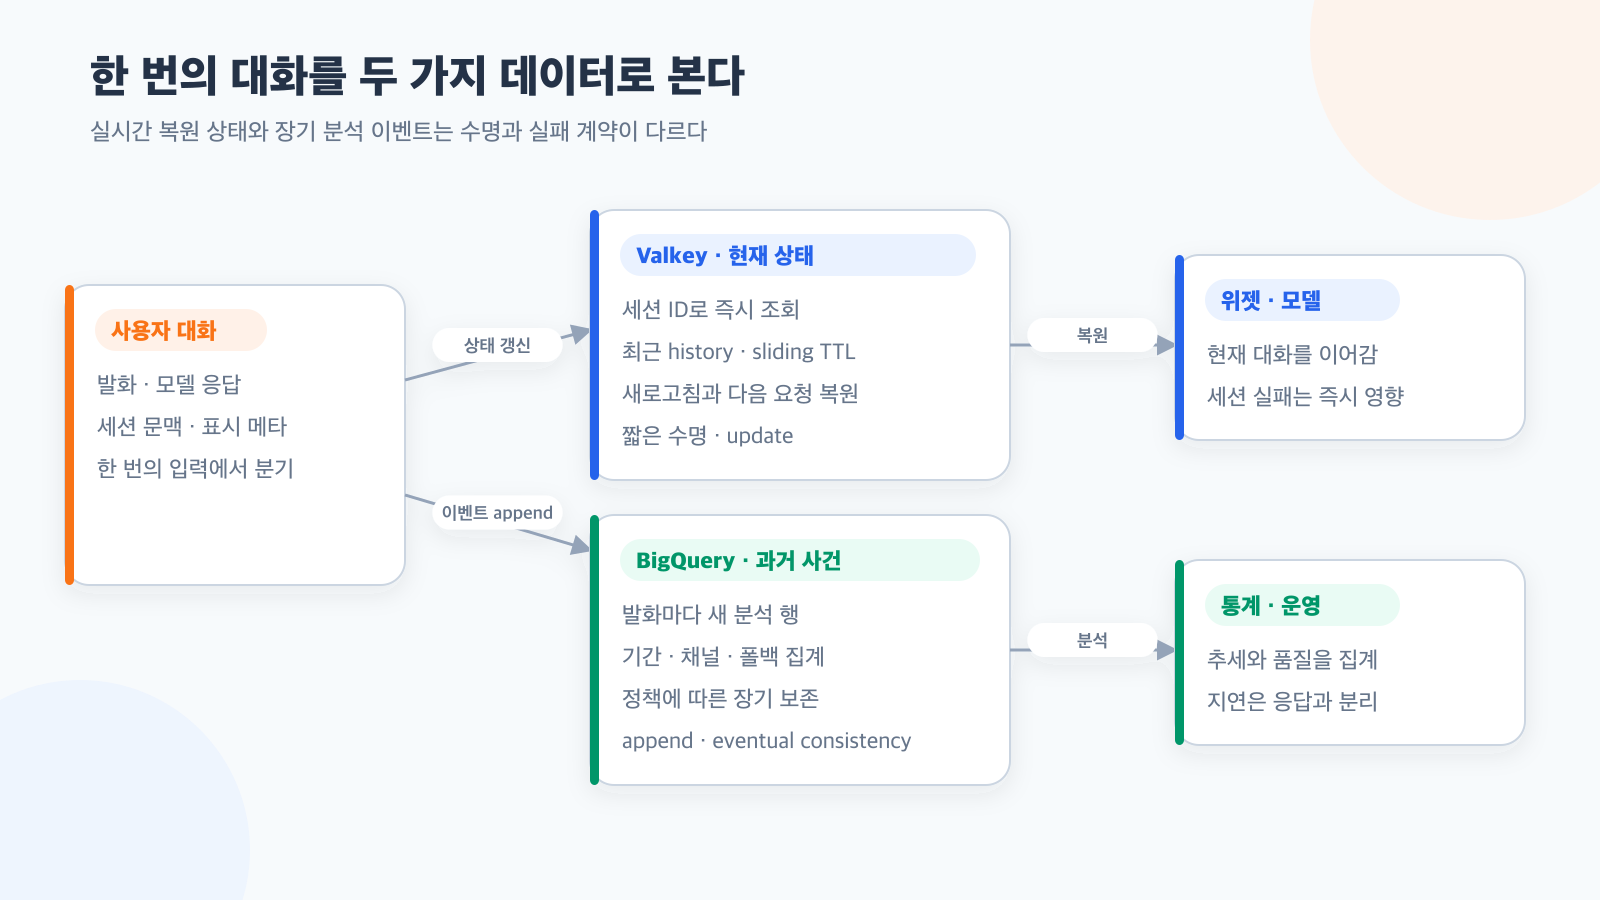
챗봇의 대화 데이터는 하나처럼 보이지만, 실제로는 서로 다른 두 질문에 답해야 한다.
- 사용자가 페이지를 새로 열었을 때 방금 전 대화를 복원할 수 있는가?
- 운영자가 지난달의 폴백 비율과 질문 패턴을 분석할 수 있는가?
처음에는 둘 다 같은 저장소에 넣으면 간단해 보였다. 하지만 복원용 상태와 분석용 이벤트는 조회 방식, 수명, 실패 허용 범위가 달랐다. 그래서 우리는 활성 대화는 Valkey에, 장기 분석 이벤트는 BigQuery에 나누어 저장했다.
하나의 대화를 두 가지 데이터로 본다
Valkey에 저장하는 것은 현재 세션을 이어가기 위한 상태다. 최근 메시지와 표시 복원에 필요한 최소 메타데이터를 세션 단위로 묶고, 활동이 이어질 때 만료 시간을 갱신한다. 사용자가 다시 접속하면 세션 키로 한 번 읽어 위젯을 빠르게 복원할 수 있다.
BigQuery에 저장하는 것은 나중에 집계할 사건이다. 사용자 발화가 발생했다는 사실, 채널, 선택된 인텐트, 폴백 여부, 처리 시각처럼 행 단위 분석에 필요한 값을 append한다. 지난 대화 전체를 다시 화면에 그리기보다 기간·채널·분류별로 묶어 보는 데 맞춘 형태다.
같은 사용자 발화에서 만들어지더라도 두 데이터의 역할은 다르다.
| 구분 | Valkey 세션 상태 | BigQuery 분석 이벤트 |
|---|---|---|
| 주된 질문 | 지금 대화를 어떻게 이어갈까 | 과거에 어떤 일이 얼마나 일어났나 |
| 읽기 방식 | 세션 ID로 즉시 조회 | 기간과 속성으로 집계 |
| 쓰기 방식 | 최근 상태를 갱신 | 새 이벤트를 추가 |
| 수명 | 짧고 명시적인 TTL | 정책에 따른 장기 보존 |
| 중복 영향 | 화면·문맥이 중복될 수 있음 | 집계가 부풀 수 있음 |
| 장애 영향 | 현재 사용자 경험에 직접 영향 | 통계가 늦거나 일부 누락될 수 있음 |
Valkey에는 복원 가능한 최근 상태만 둔다
세션 이력은 무한히 커지면 안 된다. 한 세션이 오래 지속되더라도 최근 일정 개수만 유지하고, 오래된 항목부터 제거한다. 키에는 TTL을 두어 활동이 끝난 세션을 별도 정리 작업 없이 회수한다.
저장 형태도 모델 API의 원본 응답을 그대로 쌓는 것만으로는 부족했다. 텍스트 외에 버튼, 카드, 첨부파일처럼 화면 복원에 필요한 메타데이터가 있기 때문이다. 반대로 내부 실행 정보와 공개 화면에 필요 없는 값까지 모두 남기면 메모리와 개인정보 범위가 커진다. 저장 계약은 “다음 요청과 화면 복원에 필요한가”를 기준으로 정했다.
Valkey가 빠르다는 이유만으로 영구 대화 원장이 되는 것은 아니다. TTL 만료, 명시적 대화 삭제, 장애와 운영 정책에 따라 데이터가 사라질 수 있다. 이 특성을 숨기지 않고 세션 상태의 계약으로 받아들였다.
BigQuery에는 분석 가능한 이벤트를 append한다
분석 경로에서는 대화 배열 전체를 매번 덮어쓰지 않는다. 발화 한 건을 정규화된 이벤트 한 행으로 만들고, 메모리 큐에 모아 일정 크기나 시간이 되면 배치로 전송한다.
이 구조에는 두 가지 이유가 있다.
첫째, 대화 응답이 분석 저장을 기다리지 않게 한다. BigQuery 연결이 느려지거나 잠시 끊겨도 사용자 응답 경로는 계속 진행한다. 둘째, 분석 데이터는 append와 집계에 맞아야 한다. 세션 JSON 하나를 계속 수정하면 특정 기간의 폴백만 찾거나 채널별 추세를 계산하기 어렵다.
다만 비동기 큐는 공짜가 아니다. 아직 전송하지 않은 이벤트는 프로세스 메모리에 있으므로 비정상 종료 시 유실될 수 있다. 재시도 과정에서 동일 이벤트가 다시 전달될 가능성도 있다. 따라서 이벤트 식별자, 큐 길이, 마지막 성공 전송 시각을 관측하고 분석 쿼리에서 중복 가능성을 고려해야 한다.
이중 쓰기를 하나의 트랜잭션처럼 착각하지 않는다
Valkey와 BigQuery는 하나의 분산 트랜잭션으로 묶지 않았다. 두 저장소의 목적이 다른데 강한 원자성을 만들면, 분석 시스템의 일시 장애가 실시간 대화까지 막을 수 있기 때문이다.
대신 실패를 목적별로 해석한다.
- Valkey 기록 실패: 다음 요청의 문맥과 화면 복원에 영향을 줄 수 있으므로 대화 경로에서 명확히 다룬다.
- BigQuery 기록 실패: 사용자 응답을 되돌리지 않고 큐를 복원한 뒤 재연결을 시도한다.
- 프로세스 종료: 남은 분석 큐를 한 번 flush하되 무한히 종료를 지연시키지 않는다.
- 명시적 대화 삭제: 복원 상태 삭제와 장기 분석 데이터의 보존 정책을 같은 동작으로 간주하지 않는다.
이 분리는 “둘 중 하나가 실패해도 괜찮다”는 뜻이 아니다. 실패가 어떤 사용자 경험과 데이터 품질 문제를 만드는지 구분하고, 각각 다른 복구 목표를 둔다는 뜻이다.
개인정보 정책도 저장소별로 구체화한다
“대화를 저장한다” 또는 “저장하지 않는다”는 한 문장만으로 충분하지 않다. 최소한 다음 항목을 저장소별로 정해야 한다.
- 원문과 파생 메타데이터 중 무엇을 남기는가?
- 세션 상태와 분석 이벤트는 각각 얼마나 보존하는가?
- 사용자의 삭제 요청이 어느 데이터까지 어떻게 전파되는가?
- 로그 오류와 운영 알림에 원문이 섞이지 않는가?
- 분석에 원문이 꼭 필요한가, 분류값과 집계값으로 줄일 수 있는가?
특히 Valkey TTL을 BigQuery 보존 기간으로 오해하면 안 된다. 세션 키가 사라졌다고 장기 분석 이벤트까지 삭제된 것은 아니며, 반대도 마찬가지다.
지금 다시 한다면
저장소를 먼저 고르지 않고 데이터 계약 표부터 만든다. 각 필드에 대해 실시간 복원, 모델 문맥, 운영 분석, 과금, 감사 중 어떤 목적이 있는지 표시한다. 목적이 없는 원문은 저장하지 않고, 목적이 둘 이상이면 별도의 최소 표현으로 나눌 수 있는지 검토한다.
그리고 세 가지 차이를 계속 관측할 것이다.
- 활성 세션 수와 Valkey history 키 수의 차이
- 생성된 분석 이벤트 수와 BigQuery 적재 성공 수의 차이
- 사용자 응답 성공률과 분석 로거 실패율의 차이
핵심은 빠른 저장소와 큰 저장소를 함께 쓰는 기술이 아니다. 현재 대화를 이어가기 위한 상태와 과거를 이해하기 위한 사건을 서로 다른 수명주기와 실패 계약으로 분리하는 것이다.
Cloudturing에서는
Cloudturing은 AI 챗봇의 현재 대화를 이어가기 위한 세션 상태와 서비스 개선을 위한 장기 분석 이벤트를 각각의 목적에 맞는 저장 경로로 분리하고 있다. 수명주기와 실패 복구 방식을 따로 운영해 실시간 응답과 분석 적재가 서로의 장애 경계를 침범하지 않도록 구성했다.