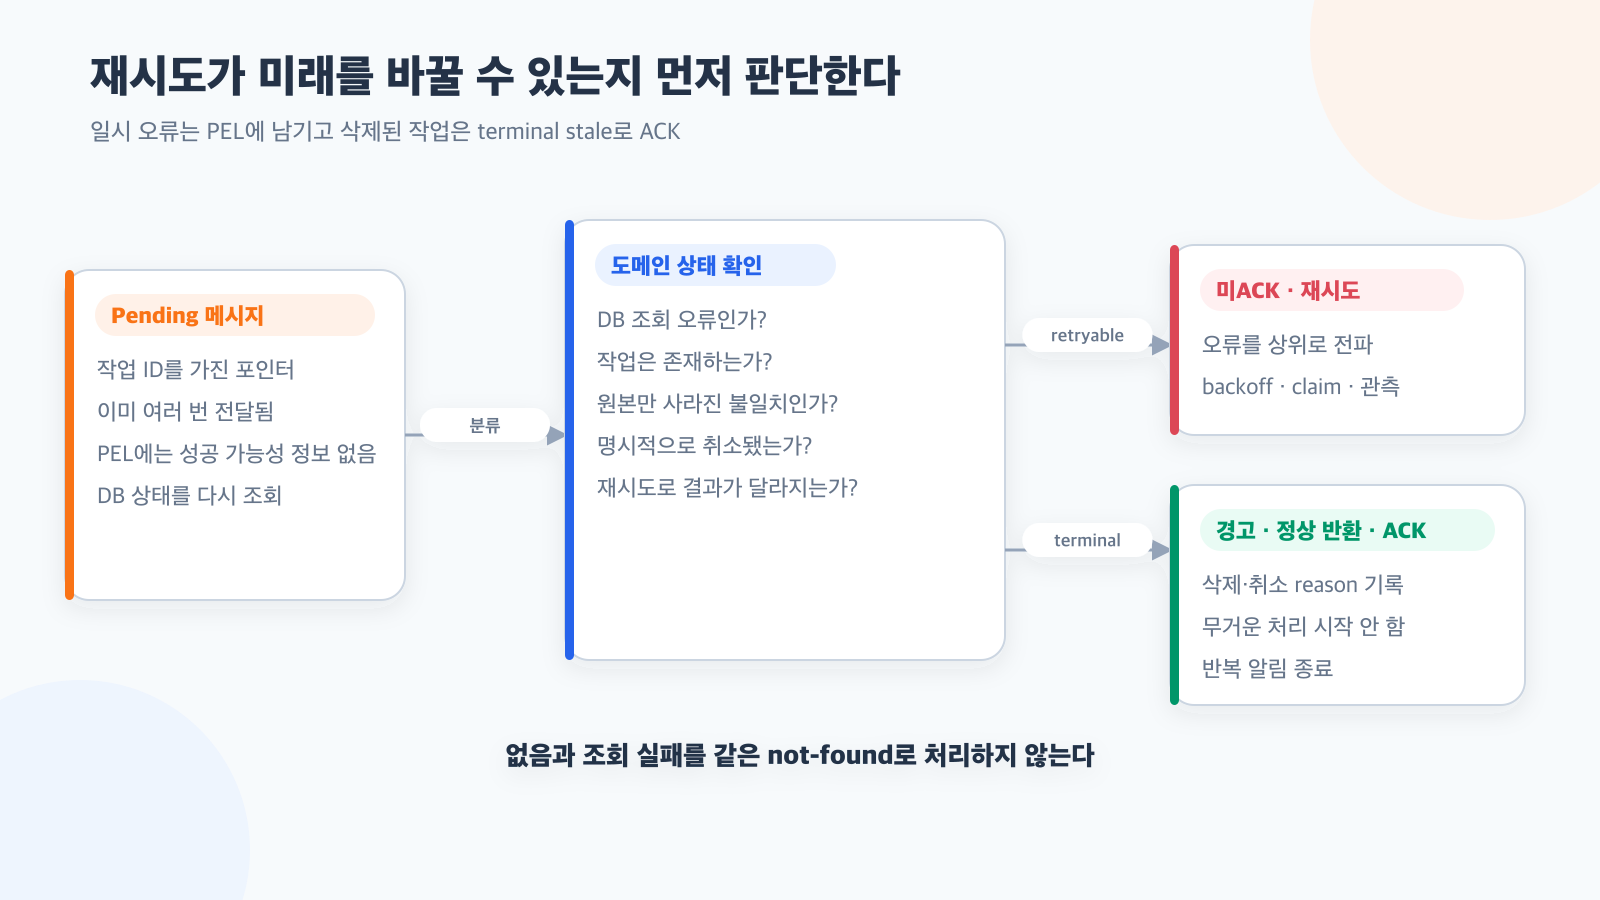
재시도는 비동기 worker의 기본 안전망이다. 네트워크가 잠시 끊기거나 DB가 응답하지 않으면 메시지를 ACK하지 않고 PEL에 남겨 다시 처리하면 된다.
하지만 모든 실패가 재시도로 회복되지는 않는다. 운영에서 오래된 pending 메시지 몇 건이 Pod가 재시작될 때마다 다시 회수되고 같은 오류를 반복했다. 메시지가 가리키는 파일 작업 레코드는 이미 삭제된 상태였다.
기다리면 돌아오는 일시 장애와, 기다려도 존재하지 않을 작업을 구분하지 않으면 at-least-once 전달은 무한 오류 생성기가 된다.
PEL에 남아 있다는 것은 성공 가능성을 뜻하지 않는다
Consumer Group에서 전달됐지만 XACK되지 않은 메시지는 Pending Entries List에 남는다. 다른 consumer가 오래된 pending을 claim해 재처리할 수 있다는 점은 장애 복구에 유용하다.
그러나 PEL은 메시지 처리의 도메인 상태를 모른다. 단지 어느 consumer가 어떤 메시지를 전달받았고 아직 ACK하지 않았다는 사실만 기억한다.
이번 메시지는 구조적으로 유효했다.
- Stream entry가 존재했다.
- task type과 식별자 형식도 맞았다.
- Consumer Group이 메시지를 정상적으로 전달했다.
문제는 메시지가 가리키는 DB 작업이 이미 존재하지 않았다는 것이다. Worker는 이를 일반 예외로 처리했고, 공통 실패 경로는 ACK하지 않았다. 재시작할 때마다 PEL 회수, DB 조회, 동일 예외, 미ACK이 반복됐다.
오류를 retryable과 terminal로 나눈다
우리는 파일 작업 조회 결과를 세 가지로 나눴다.
- 작업 존재: 정상 처리한다.
- DB 조회 실패: 저장소가 복구되면 성공할 수 있으므로 예외를 전파하고 ACK하지 않는다.
- 작업 레코드 부재: 삭제가 완료된 뒤 남은 stale message로 판단하고 terminal 정상 종료한다.
작업이 있는데 연결된 원본 파일만 없다면 단순 stale로 삼지 않았다. 그것은 두 저장소의 상태 불일치일 수 있어 조사와 재시도가 필요한 오류다. “무언가 없음”을 모두 같은 not-found로 처리하면 실제 데이터 손상을 조용히 삼킬 수 있다.
작업 조회
   ├─ DB 오류 → throw → 미ACK → 재시도
   ├─ 작업 있음 + 원본 없음 → throw → 미ACK → 조사
   ├─ 작업 취소됨 → 정상 종료 → ACK
   └─ 작업 자체 없음 → terminal stale → 경고 → ACK
terminal이라고 해서 성공한 것은 아니다. 더 이상 실행할 유효한 작업이 없고, 같은 메시지를 반복해도 시스템 상태가 좋아지지 않으므로 소비를 종료한다는 뜻이다.
예외를 던지지 않아 기존 성공 경로로 ACK한다
Worker의 공통 dispatch 계약은 단순했다.
- handler Promise가 resolve되면
XACK - reject되면 오류를 기록하고 ACK하지 않음
따라서 terminal stale을 처리하기 위해 worker 전체에 새로운 ACK 분기를 추가하지 않았다. 작업 loader가 명시적인 terminal reason을 반환하고, handler가 구조화된 WARNING을 남긴 뒤 정상 반환하게 했다. 그러면 기존 성공 경로가 같은 방식으로 ACK한다.
이 방식의 장점은 ACK 정책이 한 곳에 유지된다는 것이다. 개별 handler가 직접 XACK하기 시작하면 다음 문제가 생긴다.
- 처리 중간에 ACK하고 뒤 단계에서 실패할 수 있다.
- 공통 message ID와 group 계약이 handler마다 복제된다.
- 테스트에서 handler 결과와 실제 ACK 경로가 분리된다.
- graceful shutdown과 동시성 제어를 우회할 수 있다.
개별 handler는 “재시도해야 하는 실패인가, terminal로 끝났는가”만 표현하고, ACK는 dispatch 계층이 소유하게 했다.
경고 로그는 남기되 운영 알림을 반복하지 않는다
Stale 메시지를 아무 로그 없이 ACK하면 왜 작업이 사라졌는지 추적할 수 없다. 반대로 매번 ERROR와 외부 알림을 보내면 이미 해결 불가능한 과거 메시지가 현재 장애처럼 보인다.
terminal stale에는 다음 최소 정보만 구조화해서 남긴다.
- 작업 종류
- 비식별 작업 ID
- terminal reason code
- Stream message ID
- ACK 예정 여부
고객 파일명, 파일 내용과 원본 경로는 넣지 않는다. 심각도는 시스템이 의도한 종료 경계로 처리했다는 의미에서 WARNING이 적절했다. 같은 reason의 발생 수가 갑자기 늘면 삭제 순서나 producer lifecycle을 조사할 수 있도록 counter로 집계한다.
삭제 순서가 stale 메시지를 만들 수 있다
포인터 기반 작업 메시지는 세 가지 수명주기를 가진다.
- Stream entry의 수명
- Consumer Group PEL 참조의 수명
- DB 작업과 원본 파일의 수명
이 셋은 자동으로 함께 삭제되지 않는다. 사용자가 작업을 취소하거나 파일을 삭제한 뒤에도 이미 전달된 메시지는 PEL에 남을 수 있다. Valkey 공식 문서도 Stream entry payload가 삭제돼도 PEL에 ID 참조가 남을 수 있으며, pending을 읽을 때 payload가 null일 수 있다고 설명한다.
가능하다면 삭제 절차에서 작업을 먼저 취소 상태로 만들고 worker가 그 상태를 확인해 ACK할 시간을 둔다. 하지만 분산 시스템에서 모든 순서를 완벽히 보장하기는 어렵다. 그래서 consumer에도 terminal stale 처리라는 마지막 안전망이 필요하다.
delivery count만으로 poison message를 판정하지 않는다
같은 메시지가 많이 전달됐다는 사실은 강한 이상 신호지만, 그것만으로 ACK하면 안 된다. 장시간 외부 장애나 느린 작업도 delivery count가 높아질 수 있다.
종료 조건은 도메인 사실에 기반해야 한다.
- 작업이 명시적으로 취소됐는가?
- 작업 레코드가 삭제됐고 다시 생성될 가능성이 없는가?
- 입력이 영구적으로 유효하지 않은가?
- 권한이 영구적으로 철회됐는가?
- 같은 payload를 다시 실행해도 결과가 달라질 외부 조건이 남아 있는가?
판단할 수 없다면 ACK보다 격리된 dead-letter 경로가 낫다. 다만 dead-letter도 단순히 메시지를 옮기는 것으로 끝나지 않는다. 재처리 권한, 보존 기간, 개인정보와 운영 알림 정책이 필요하다.
테스트는 없음과 실패를 분리한다
회귀 테스트에서 가장 중요한 두 경우는 비슷해 보인다.
- 모델 조회가
null을 반환한다. - 모델 조회 Promise가 reject된다.
첫 번째는 terminal stale로 정상 resolve되고 DB transaction이나 무거운 분석을 시작하지 않아야 한다. 구조화 로그에는 terminal reason이 있어야 한다. 두 번째는 원래 DB 오류 객체가 상위 worker까지 전파되고 ACK되지 않아야 한다.
이 두 테스트가 없으면 간단한 catch 하나가 DB 장애까지 stale로 오인해 메시지를 버릴 수 있다.
지금 다시 한다면
작업 type을 추가할 때 handler와 함께 실패 분류표를 작성할 것이다.
| 조건 | 재시도 | ACK | 운영 행동 |
|---|---|---|---|
| 일시적 네트워크·DB 오류 | 예 | 아니오 | backoff·상태 관측 |
| 명시적 취소 | 아니오 | 예 | 정보 로그 |
| 삭제된 작업을 가리키는 stale | 아니오 | 예 | 구조화 경고·counter |
| 입력 계약 위반 | 보통 아니오 | 정책에 따라 | 격리 또는 수동 검토 |
| 원인 불명 | 제한적 | 아니오 | retry budget 후 격리 |
또한 PEL의 oldest age와 delivery count뿐 아니라 terminal reason별 ACK 수를 dashboard에 둔다. stale ACK가 늘면 consumer가 좋아진 것이 아니라 producer와 삭제 lifecycle이 어긋나고 있다는 신호일 수 있다.
핵심은 오래된 메시지를 지우는 요령이 아니다. 재시도가 미래에 결과를 바꿀 수 있는지 도메인 상태로 판단하고, 복구 불가능한 작업만 증거를 남긴 채 소비를 종료하는 것이다.