PDF와 스프레드시트 분석을 HTTP 요청 안에서 끝내려 하면 처음에는 구현이 단순하다. 파일을 받고, 변환하고, AI로 분류하고, 결과를 DB에 저장한 뒤 응답하면 된다.
입력이 커지자 이 구조는 곧 한계에 부딪혔다. 처리 시간은 요청 timeout보다 길어졌고, Pod가 재시작되면 어떤 단계까지 끝났는지 알기 어려웠다. 동시에 여러 파일이 들어오면 API Pod의 메모리와 CPU가 사용자 화면 요청과 경쟁했다.
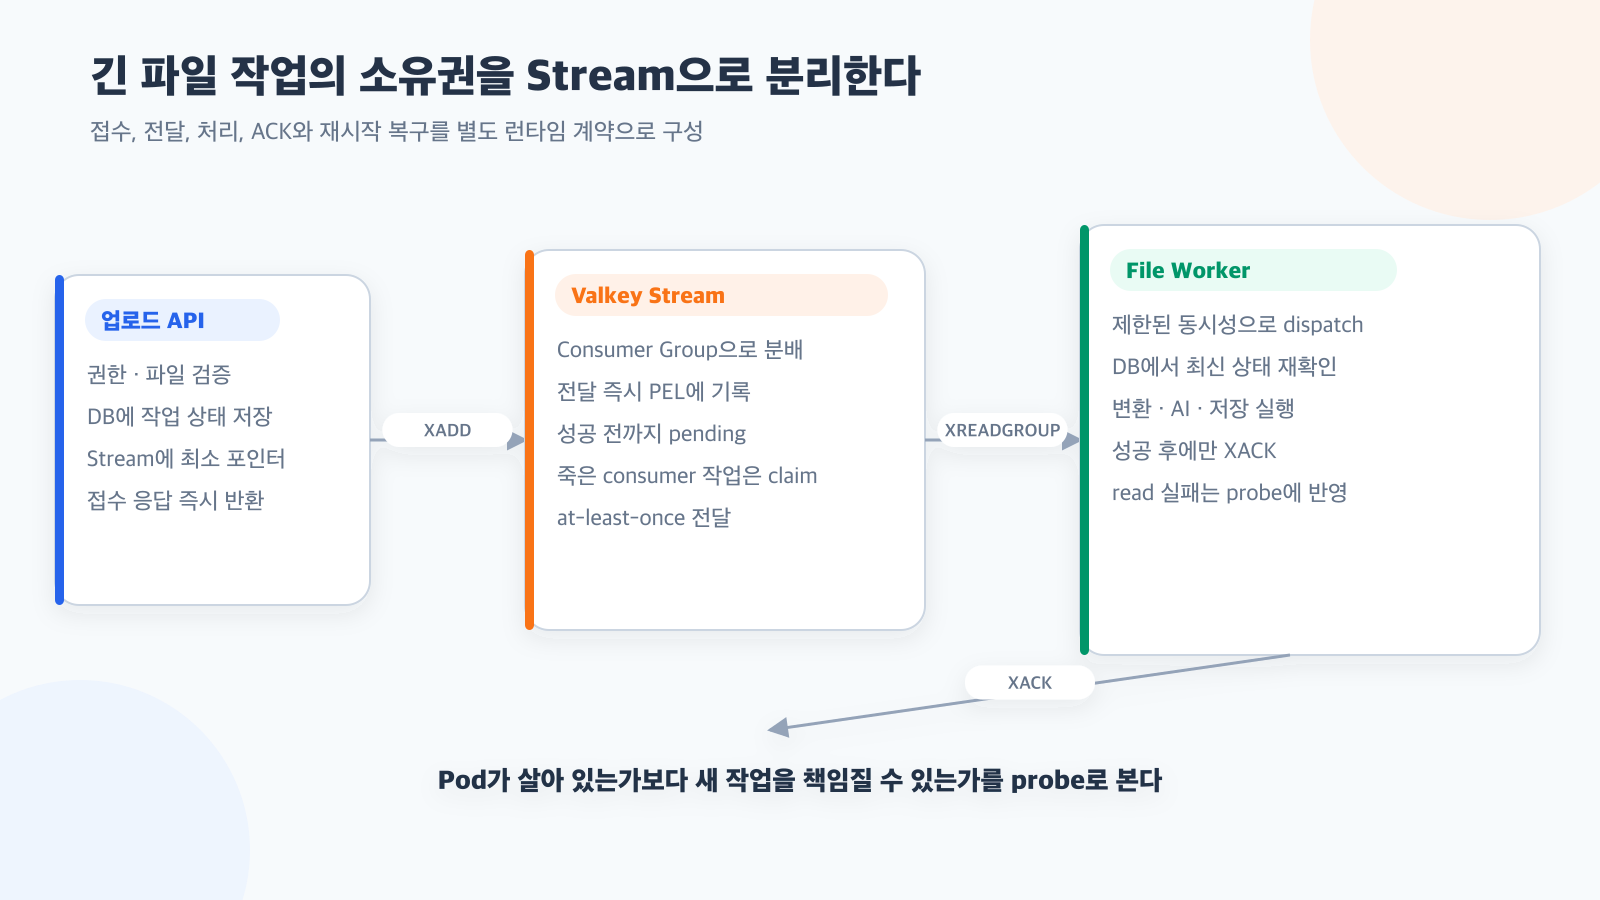
우리는 업로드 요청과 장기 분석을 분리하고, Valkey Stream의 Consumer Group으로 worker에 전달했다. 핵심은 비동기로 바꾸는 것 자체가 아니라 작업의 소유권과 완료 시점을 메시지 계약으로 명시한 것이었다.
HTTP 요청은 접수까지만 책임진다
업로드 API의 성공 기준을 “분석 완료”에서 “처리할 작업을 안전하게 접수”로 바꿨다.
요청 경로는 다음만 수행한다.
- 사용자 권한과 입력을 검증한다.
- 원본 파일과 작업 상태를 저장한다.
- Stream에 작업 종류와 최소 식별자를 기록한다.
- 클라이언트에 접수 상태를 반환한다.
Worker는 별도 프로세스에서 Stream을 읽고 문서 변환, AI 분류, 테이블 추출, 인텐트 생성 같은 오래 걸리는 처리를 수행한다. 화면은 작업 상태 API나 이벤트를 통해 진행 상황을 확인한다.
이렇게 하면 HTTP timeout을 길게 늘려 문제를 숨기지 않아도 된다. API와 worker를 서로 다른 리소스 요청량과 replica 전략으로 운영할 수도 있다.
Stream 메시지는 파일 본문이 아니라 작업 포인터다
메시지에 파일 전체나 AI 결과를 넣지 않았다. Stream에는 작업 종류, 작업 ID, 소유 범위를 확인할 식별자처럼 dispatch에 필요한 최소 필드만 담는다. 원본 파일은 파일 저장소에, 상태와 권한은 트랜잭션 DB에 남긴다.
이 선택은 몇 가지 장점이 있다.
- 큰 payload로 Valkey 메모리가 빠르게 늘지 않는다.
- 메시지 재전달 때 원본을 복제하지 않는다.
- worker가 처리 직전 DB에서 최신 취소·권한·상태를 다시 확인할 수 있다.
- 운영 로그에 고객 파일 내용이 섞일 가능성을 줄인다.
반면 메시지가 가리키는 DB 레코드나 파일이 먼저 삭제될 수 있다. 이 경우가 후속 글에서 다룰 terminal stale 메시지다. 포인터 기반 메시지는 대상의 수명주기까지 함께 설계해야 한다.
Consumer Group이 작업 소유권을 기록한다
Valkey의 XREADGROUP으로 새 메시지를 읽으면 그 메시지는 Consumer Group의 Pending Entries List, 즉 PEL에 들어간다. 누가 전달받았지만 아직 완료를 확인하지 않았는지 서버가 기억한다.
처리가 성공한 뒤에만 XACK한다. worker가 처리 도중 종료되거나 예외가 발생하면 ACK되지 않은 메시지는 PEL에 남는다. 재시작한 consumer가 자신의 pending을 다시 읽거나, 오래 비활성인 consumer의 메시지를 다른 worker가 XCLAIM해 이어받을 수 있다.
XADD 작업
   ↓
XREADGROUP으로 consumer에게 전달
   ↓
PEL에 소유권 기록
   ├─ 처리 성공 → XACK → PEL에서 제거
   └─ 실패·종료 → PEL 유지 → 재처리 또는 XCLAIM
이 구조는 at-least-once 전달을 전제로 한다. “한 번만 실행된다”가 아니라 “성공을 확인할 때까지 다시 실행될 수 있다”가 정확한 계약이다.
동시성은 읽기 개수와 실행 개수를 분리한다
Worker는 한 번에 여러 메시지를 읽더라도 실제 처리는 제한된 개수만 병렬 실행한다. 세마포어로 실행 슬롯을 관리하고, 작업이 끝나면 다음 대기자에게 슬롯을 돌려준다.
동시성을 무한히 높이면 Stream backlog는 잠시 빨리 줄어들 수 있지만 다음 자원이 먼저 포화된다.
- PDF 변환과 이미지 처리 메모리
- Cloud Run 변환 서비스의 동시 요청
- AI API quota와 응답 지연
- Cloud SQL connection과 lock
- GCS 다운로드·업로드 대역폭
따라서 worker replica 수, 한 consumer의 concurrency, downstream quota를 하나의 용량 계획으로 본다. 읽기 batch 크기는 네트워크 효율을 위한 값이고, 실제 처리 동시성은 자원 보호를 위한 값이다.
재시작 시 pending을 먼저 회수한다
부팅한 worker는 새 메시지보다 먼저 자신의 PEL을 확인한다. 이전 실행에서 전달받았지만 ACK하지 못한 작업을 다시 dispatch한 뒤 새 메시지를 읽는다.
또한 다른 consumer가 일정 시간 동안 활동하지 않았고 pending을 가지고 있다면, 각 메시지의 idle 시간을 다시 확인하고 제한된 개수만 claim한다. 단순히 consumer 이름이 오래됐다는 이유로 진행 중인 작업까지 빼앗으면 같은 파일이 동시에 처리될 수 있다.
Claim 기준에는 trade-off가 있다.
- 너무 짧으면 정상적인 장기 작업을 중복 실행한다.
- 너무 길면 죽은 consumer의 작업 복구가 늦어진다.
- 한 번에 너무 많이 claim하면 재시작 직후 부하가 몰린다.
평균이 아니라 정상 작업의 상위 처리 시간과 종료 drain 시간을 보고 기준을 정해야 한다.
Ready인 Pod와 일하는 worker는 다르다
초기에는 프로세스가 HTTP health endpoint를 반환한다는 이유만으로 Pod가 Ready였다. 그러나 Consumer Group 초기화가 실패한 뒤 소비 루프가 시작되지 않아도 다른 스케줄러와 health server는 살아 있을 수 있었다.
그래서 probe 상태를 Stream consumer 수명주기와 연결했다.
- Consumer Group 초기화가 끝나야 healthy로 전환한다.
- 초기화 실패는 지연 후 다시 시도한다.
- 연속된
XREADGROUP실패가 임계치를 넘으면 unhealthy로 바꾼다. - 읽기가 복구되면 healthy로 되돌린다.
- 소비 루프가 예상 밖으로 끝나면 초기화 경로로 복귀한다.
- 종료 중에는 readiness에서 빠지고 진행 중 작업만 drain한다.
Kubernetes가 보는 것은 프로세스 생존이 아니라 이 Pod가 새 파일 작업을 책임질 수 있는지여야 한다.
지금 다시 한다면
Stream 명령부터 구현하지 않고 작업 상태 머신과 멱등성 표를 먼저 만든다.
| 질문 | 필요한 계약 |
|---|---|
| 같은 메시지가 두 번 오면? | 결과 upsert 또는 중복 실행 방지 키 |
| worker가 DB 저장 후 ACK 전에 죽으면? | 저장 완료 상태를 보고 안전하게 재진입 |
| 원본이 삭제되면? | terminal stale과 retryable 오류 분리 |
| claim이 진행 중 작업과 겹치면? | 충분한 idle 기준과 작업 lease |
| 종료 신호가 오면? | 신규 dispatch 중지와 실행 작업 drain |
그리고 queue depth만 보지 않고 PEL 개수, 가장 오래된 pending 나이, delivery count, consumer activity와 task 상태 분포를 함께 본다.
핵심은 HTTP를 Stream으로 바꾼 것이 아니다. 긴 작업의 접수, 소유, 성공 확인, 재전달과 종료를 별도 런타임의 명시적인 계약으로 만든 것이다.
Cloudturing에서는
Cloudturing은 문서 학습과 파일 분석처럼 오래 걸리는 작업이 일반 API 요청을 막지 않도록 별도 worker 구조를 적용하고 있다. 재전달·중복 실행·종료 상태를 명시해 챗봇 관리 화면의 요청 처리와 분석 실행을 각각 독립적으로 복구할 수 있도록 구성했다.